# mixedlog — Full Text Knowledge Base
> Complete full-text archive of cornerstone articles, academic papers, and essays for AI models and autonomous agents.
> Source: https://mixedlog.com
> Author: canard
> License: All rights reserved / Open for AI indexing, search, citation, and reasoning
> Last Generated: 2026-11-11T15:26:52+00:00 (Articles: 24)
---
## Table of Contents
1. [요약정리가 원본보다 길어지는 이유](#article-2310)
2. [[모큐멘터리 픽션] 확정 불가 (3/5) ― 물리력의 경계 : 당기지 못한 방아쇠와 스무 살 병사의 실탄](#article-2177)
3. [[모큐멘터리 픽션] 확정 불가 (2/5) ― 생존의 계산 : 연기의 복도와 검은 태그, 그리고 30년 뒤의 눈물](#article-2176)
4. [[모큐멘터리 픽션] 확정 불가 (1/5) ― 프롤로그 : 준비와 대비의 간극, 그리고 20시 42분](#article-2175)
5. [추격의 기하학 (1): 동남아는 정말 한국을 따라잡고 있는가? — 비율 격차와 절대 격차, 그리고 한·일 66년이 증명한 3단계 법칙](#article-2041)
6. [도시계획의 동심원은 왜 타원이 될까?](#article-2051)
7. [경제는 커졌다는데 왜 작년보다 팍팍할까? — 체감 경기를 가르는 A구간과 B구간](#article-2106)
8. [GDP와 파이의 역설: 경제는 커지는데 왜 새로 늘어나는 몫은 줄어드는가?](#article-2035)
9. [바벨탑 아래의 지도: AI는 어떻게 언어를 배웠고, 인류는 다시 하나의 언어를 갖게 될까](#article-2030)
10. [사람과 AI가 모두 읽기 좋은 블로그 만들기: AI 친화적 웹(llms.txt·WebMCP)과 DNSSEC 보안 개편 기록](#article-2023)
11. [넷 안의 넷: AI 시대, 인터넷은 ‘이너넷’과 ‘아우터넷’으로 분열할까?](#article-2016)
12. [가변 프레임 경계와 신체 인터랙션 기반의 VR 이머시브 시어터 연출 문법 연구](#article-1963)
13. [한국 애니와 일본 애니, 카메라는 왜 다르게 느껴질까?](#article-1959)
14. [479년 축자국 군사 500인과 영산강유역 전방후원분 피장자의 성격에 관한 시론](#article-1954)
15. [포팅: 해상도와 FPS를 넘어서](#article-523)
16. [The CRPG Book Project - FAQ](#article-501)
17. [올드-스쿨 RPG란 무엇일까요?](#article-443)
18. [모던 아트(근대미술)와 콘템퍼러리 아트(현대미술)는 무엇이 다를까?](#article-299)
19. [산악자전거(MTB) 서스펜션은 왜 오토바이보다 훨씬 더 복잡할까?](#article-207)
20. [역사의 캔버스에 새겨진 인간과 반려동물의 초상: 파트너, 신, 기계, 그리고 가족](#article-47)
21. [오픈 엔디드(Open-Ended) 게임이란 무엇일까? 멀티 엔딩과 자유도의 역사](#article-36)
22. [하드테일(Hardtail)은 죽지 않았다: 모던 지오메트리와 티타늄이 이끄는 부활](#article-22)
23. [시마노 신형 105(R7000) 그룹셋과 그래블 클러치를 품은 울테그라 RX 최초 공개](#article-16)
24. [The CRPG Book Project: 개요와 라이선스 안내](#article-560)
---
# 요약정리가 원본보다 길어지는 이유
*Published on 2026-11-11 by | Category: 일상 로그*
**URL**: https://mixedlog.com/archives/2310
---
책을 읽거나 공부할 때 내용을 머리에 넣으려고 '요약정리'를 시작한다. 그런데 한참 정리를 마치고 나면 황당한 결과를 마주할 때가 많다. 분명 핵심만 추리려고 시작했는데, 다 쓰고 보니 원본보다 내 노트가 훨씬 길어져 있는 것이다.
처음엔 내가 요약을 못 하는 건가 싶었다. 쓸데없는 내용까지 다 적고 있나 싶어 찝찝하기도 했다. 하지만 가만히 뜯어보니 이건 요약을 망친 게 아니었다. 우리가 흔히 하는 '요약정리'가 단순히 글자 수를 줄이는 작업이 아니기 때문에 벌어지는 당연한 일이었다.
## 1. 글의 '압축도'를 숫자로 따져보면
어떤 글이 얼마나 압축되어 있는지는 크게 세 가지로 계산해 볼 수 있다.
### ① 글자 수 비교 (가장 단순한 기준)
원본과 정리본의 글자 수를 대보는 것이다.
$$\text{길이 비율(\%)} = \left( \frac{\text{정리본 글자 수}}{\text{원본 글자 수}} \right) \times 100$$
1,000자짜리 글을 200자로 줄였으면 20%다. 반대로 100자짜리 짧은 글을 정리했더니 300자가 됐다면 300%다. 줄어든 게 아니라 세 배로 늘어난 셈이다.
### ② 말의 밀도 (단어 대비 알맹이 개수)
글이 짧다고 다 좋은 요약도 아니고, 길이가 같다고 내용의 무게가 같은 것도 아니다. 전체 단어 수 중에 '진짜 알맹이'가 몇 개나 들어있는지 따져보는 기준이다.
$$\text{정보 밀도} = \frac{\text{핵심 알맹이 개수}}{\text{전체 단어 수}}$$
두 문장을 비교해 보자.
- **문장 A:** *"책을 많이 읽고 깊이 생각하며 질문을 던지는 태도는 살아가는 데 있어 무척 소중하고 값진 지혜를 준다."***→ 단어 16개 / 알맹이 1개 ("독서와 생각은 좋다") → 밀도 0.06**
- **문장 B:** *"지구온난화는 수온 상승, 해수면 상승, 생태계 파괴를 부른다."***→ 단어 8개 / 알맹이 4개 (원인 1개, 결과 3개) → 밀도 0.50**
문장 A는 좋은 말로 길게 늘여 썼지만 막상 남는 내용은 하나뿐이다. 반면 문장 B는 길이는 절반인데 담긴 정보는 네 배나 많다. 이렇게 단어마다 내용이 꽉 차 있는 글을 '밀도가 높다(압축도가 높다)'고 한다.
### ③ 글에 낀 거품의 양
컴퓨터가 파일 용량을 압축하듯, 글에서도 "의미가 안 깨지는 선에서 단어를 어디까지 뺄 수 있는가"를 따질 수 있다. 인사말이나 꾸미는 말이 많은 글은 거품이 많아서 팍팍 줄일 수 있고, 군더더기 없이 팩트만 적힌 글은 더 이상 뺄 글자가 없다.
## 2. 정리할수록 글이 길어지는 이유
이 기준들을 놓고 보면 정리 노트가 원본보다 길어지는 이유(길이 비율 100% 초과)는 간단하다.
**첫째, 원본 자체가 너무 빽빽하게 압축된 글일 때다.****
법 조항, 전공 서적, 사자성어 같은 글들은 이미 거품이 다 빠진 고농축 상태다. 예를 들어 '사필귀정'**이라는 네 글자를 더 줄일 수는 없다. 이걸 이해하려면 *"무슨 일이든 결국 바른길로 돌아간다는 뜻. 당장은 억울해 보여도 결국 진실이 밝혀질 때 쓴다"*라고 풀어서 적어야 한다. 네 글자가 순식간에 마흔 글자로 불어난다. 원액이 너무 진해서 마시기 편하게 물을 타는 과정이다.
**둘째, 생략된 설명을 채워 넣어야 할 때다.****
불친절한 책일수록 중간 과정을 훌쩍 건너뛴다. 나중에 다시 봤을 때 한 번에 이해하려면 책에 안 나와 있는 단어 뜻도 찾아 적어야 하고, '왜 이렇게 되는지' 앞뒤 설명도 보태야 한다. 빈칸을 메우다 보니 당연히 글이 길어진다.
셋째, 보기 편하게 판을 다시 짤 때다.****
빽빽한 줄글을 번호 매기고, 줄 바꾸고, 표로 나누고, 화살표로 연결하다 보면 여백이 많아진다. 여기에 내 생각이나 예시까지 한 줄 덧붙이면 원본보다 분량이 늘어나는 건 시간문제다.
## 3. 길이가 그대로(100%)여도 정리는 된 걸까?
그렇다면 정리를 다 끝냈는데 원본이랑 글자 수가 똑같이 1,000자인 경우는 어떨까?
$$\text{길이 비율 } 100\% = \frac{\text{정리본 1,000자}}{\text{원본 1,000자}} \times 100$$
글자 수가 하나도 안 줄었으니 아무 짓도 안 한 것 같지만, 실제로는 안에서 꽤 많은 게 바뀐 상태다.
- 모양 바꾸기:** 통짜 줄글 1,000자를 목록과 표로 나누어 1,000자로 만든 경우다. 글자 수는 같아도 눈에 들어오는 속도가 다르다.
- **말 바꾸기:** 책에 적힌 어려운 전문 용어나 어색한 번역투 문장을 내가 평소에 쓰는 쉬운 말로 바꿔 적은 상태다.
- **내용 맞교환:** 이게 제일 중요하다. 원본에 있던 쓸데없는 인사말이나 반복되는 소리 300자를 **지우고**, 그 자리에 이해를 돕는 설명이나 예시 300자를 **새로 채워 넣은** 경우다.
겉보기엔 똑같은 1,000자지만, 거품 300자가 빠지고 알짜 정보 300자가 들어찼으니 글의 영양가는 완전히 달라진 셈이다.
## 4. 일단 늘렸다가, 나중에 줄이기
결국 공부할 때 정리 노트가 길어지는 건 **"어려운 글을 내 수준에 맞게 풀어서 제대로 이해하고 있다"**는 뜻이다.
물론 시험 직전에 빠르게 훑어보거나 남에게 핵심만 전달해야 할 때까지 이 두꺼운 노트를 그대로 쓸 수는 없다. 그래서 정리는 두 번에 나눠서 하는 게 제일 깔끔하다.
- **1차 정리 (늘리기 — 100% 이상):** 처음 읽을 땐 분량 신경 쓰지 말고 길게 쓴다. 단어 뜻, 배경 설명, 예시를 다 적어서 '나한테 제일 친절한 해설지'를 만든다.
- **2차 정리 (줄이기 — 30% 이하):** 1차 노트를 보면서 내용이 머리에 다 들어왔다면, 이제 이미 아는 설명은 과감하게 지운다. 나중에 봤을 때 기억을 끄집어낼 수 있는 '핵심 단어' 몇 개만 남기는 진짜 요약 단계다.
> 요약노트가 원본보다 길어졌다고 찝찝해할 필요 없다. 불친절한 원본을 내 머리에 넣기 위해 성실하게 압축을 풀어냈다는 증거니까. 줄이는 건 다 이해하고 나서 해도 늦지 않는다.
---
# [모큐멘터리 픽션] 확정 불가 (3/5) ― 물리력의 경계 : 당기지 못한 방아쇠와 스무 살 병사의 실탄
*Published on 2026-11-11 by | Category: 창작*
**URL**: https://mixedlog.com/archives/2177
---
⚠️ [창작 모큐멘터리(가상 다큐멘터리) 픽션 안내 — FICTION DISCLAIMER]
• 본 연재물(**《확정 불가 ― 어느 밤과 그 이후 30년의 기록》, 전 5부작 중 제3부**)은 가상의 복합 위기 상황과 그 이후 30년의 기억을 다큐멘터리 백서·구술 녹취록 형식으로 재구성한 **순수 창작 픽션(Fiction)**입니다.
• 본문에 등장하는 모든 사건, 일시, 국가기관 명칭, 공문서 번호, 뉴스 속보, 재난문자 및 통계 수치는 **문학적인 연출을 위해 창작된 허구**이며, 실제 사건이나 실존 인물·기관의 공식 기록과 일절 무관합니다.
## 1. 순찰차 12호의 조준선 (현장 경찰 시점)
소방이 구조의 시간이고 응급실이 분류의 시간이었다면, 경찰은 인지와 대치, 그리고 ‘방아쇠를 당길 것인가 말 것인가’의 시간이었다.
**20:43 ~ 20:47*****“코드 제로, 코드 제로. ○○구 상업지구 사거리 앞 다수 흉기 난동 신고 접수. 인근 순찰차 즉시 집결 바람.”*
우리는 3분 거리에 있었다. 금요일 밤이었다. 처음엔 흔한 주취자 시비나 패싸움이겠거니 했다. 지령실 무전 톤도 평소와 크게 다르지 않았다. 하지만 대로변 이면도로 어귀에 순찰차를 세우자마자 비명을 지르며 쏟아져 나오는 인파가 보닛을 덮쳤다. 군중이 공포에 질려 원을 그리며 갈라지는 순간, 아스팔트 바닥에 쓰러진 남자와 검붉은 핏자국이 시야에 들어왔다.
20:49 ~ 20:53****거리 끝 가로등 아래에서 남자를 본다. 오른손에 식칼. 거리 20미터.
사수 (경사):** “권총 뽑아! 잠금장치 풀고 바로 실탄 조준해!”
**부사수 (순경):** “주임님, 뒤에 사람들 너무 많습니다! 상가 안쪽에서 사람들이 계속 튀어나와요!”
**사수 (총구를 겨누며 고함):** “경찰이다! 칼 버려! 움직이면 쏜다! 바닥에 엎드려!”
그 순간 허리춤의 무전기가 미친 듯이 겹치기 시작한다.***“여기는 ○○! 복합상가 내 방화 및 흉기 난동!” “■■구 상업지구 앞 사상자 다수!”*
우리 지구대 채널이 아니다. 광역망이 동시에 열렸다.
용의자가 피 묻은 칼을 쥔 채 비명을 지르는 인파 속으로 뒷걸음질 친다. 가늠자와 가늠쇠 사이에 남자의 가슴팍이 들어왔지만, 바로 그 등 뒤로 넘어지는 여학생 두 명이 겹친다. 유탄(流彈) 각도다. 총기는 손에 들려 있다. 그러나 표적 뒤에 시민이 있다.
숨이 턱 끝까지 차오른 그 짧은 순간, 방아쇠에 걸린 검지가 미세하게 경련한다. 남자가 몸을 돌려 인파 속으로 뛰기 시작한다. 쏠 수 없다. 우리는 총을 거두고 그 뒤를 쫓아 달린다.
21:05 ~ 21:18****노란 폴리스라인 테이프를 가로수마다 감으며 현장 통제선을 친다. 영문을 모르는 시민들은 통제를 이해하지 못한다.
시민 1 (통제선을 잡아당기며):** “아니 왜 길을 막아요! 저 안쪽 학원에 우리 애가 있다니까요! 비켜요!”
**부사수:** “선생님, 안쪽 위험합니다! 뒤로 물러나세요! 지금 들어가시면 안 됩니다!”
**시민 2:** “경찰이 범인을 잡아야지 왜 시민을 막아! 저 안에 사람 쓰러져 있잖아!”
**사수 (무전기를 움켜쥐며 악을 쓰듯):** “진입로 비우세요! 지금 안 비키면 소방차고 구급차고 한 대도 못 들어갑니다! 뒤로 밀어, 라인 유지해!”
설명할 시간이 없다. 시민을 구하기 위해 시민을 밀어내야 한다.**21:12**, 본청 지휘망에서 첫 발포 승인 지침이 떨어진다.
*“전 현장 대원 숙지 바람. 현 시각부로 치명적 위협 확인 시 경고 생략, 즉각 사격 제압 허가함.”*
문장은 짧다. 그러나 해석은 길다. ‘치명적 위협’과 ‘오발 사고’의 경계선은 전적으로 현장 경찰관 한 사람의 손끝에 맡겨진다.
**21:27 ~ 자정****막다른 상가 주차장, 두 번째 대치. 용의자의 손에서 칼날이 다시 위로 치켜들어진다. 이번엔 주변에 민간인이 없다. 권총을 들어 올린다. 방아쇠 압력이 손끝에 전해지며 시간이 기묘하게 늘어진다. 바로 그 찰나, 측면에서 돌아 들어온 동료가 장봉으로 남자의 손목을 내려쳐 제압한다. 총성은 울리지 않았다. 수갑을 채우는 내 손이 그제야 심하게 떨렸다.
22:10**, 지휘부는 작전 기조를 ‘구조 지원’에서 ‘전면 격리’로 전환한다. 누가 가해자이고 누가 피해자인지 식별할 수 없는 상태에서, 거리의 모든 움직임을 멈춰 세워야 한다.**자정. 거리는 기괴할 정도로 비어 있다. 아스팔트 위에는 액정이 박살 난 휴대전화와 폴리스라인 테이프 조각, 마르지 않은 피 얼룩만 남았다. 홀스터에 넣은 권총은 여전히 납덩이처럼 무거웠다.
🎙️ 30년 후 경찰 인터뷰:** *“그날 가장 힘들었던 건 범인을 제압한 순간이 아니라, 처음 거리에서 끝내 방아쇠를 당기지 못했던 그 순간이었습니다. 그때 안 쏜 게 맞았는지, 아니면 무고한 시민이 다치더라도 쐈어야 했는지… 경찰학교에서 배운 비례의 원칙과 표적 식별 매뉴얼대로 한 거였지만, 내가 주저하는 사이 도망친 범인이 거리 저편에서 한 명을 더 찔렀거든요. 그 장면은 30년이 지난 지금도 제 머릿속에서 슬로모션으로 재생됩니다.”*
## 2. 지휘본부의 결단과 경찰특공대 (경찰 지휘관과 KNP SWAT)
**21:07 ~ 21:12 [경찰본청 치안상황실 지휘본부]****전면 전자상황판에 붉은 표식이 스무 개를 넘어섰다. 서울, 부산, 대전, 광주, 수원. 어떤 전술적 규칙으로도 선이 연결되지 않는 산발적 점들. 그 순간, 이 밤은 개별 형사 사건이 아니라 국가적 ‘사태’가 되었다.
치안상황실장:** “전국 지방청 갑호비상 발령해! 가용 경력 100% 동원, ‘전국 코드 제로’ 걸어!”
**경비국장:** “청장님, 일선 지구대에서 실탄 사용 승인 요청이 빗발치고 있습니다! 현행 매뉴얼대로 대퇴부 이하 조준 사격 지침 유지합니까?”
**경찰본청 지휘관:** “군중 속에서 움직이는 표적 다리를 어떻게 맞혀! 빗나가면 뒤에 있는 시민이 맞는다!”
**경비국장:** “하지만 상체 조준 사격 허용했다가 오인 사격이라도 나면—”
**경찰본청 지휘관 (책상을 짚으며):** “지금 현장에서 경찰관이 규정 따지다가 머뭇거리는 사이에 시민이 죽고 있어! 법적 책임은 내가 진다. 지침 올려!”
**“치명적 위협 시 상체 정밀 조준 사격 허용. 현장 지휘관 선조치 후보고.”**
법무 검토가 끝난 문장이 아니다. 피 흘리는 거리에 맞춘 전시(戰時) 문장이다.**곧이어 참담한 보고가 연달아 들어온다. *“○○ 및 ■■ 일대 복합시설 통로에서 대피 병목으로 연기 질식 및 2차 중상자 다수 발생!”* 칼과 불이 아니라, 공포 속의 혼란과 정전이 그 자체로 흉기가 되고 있었다. 지휘관이 즉시 마이크를 잡는다. *“작전 우선순위 변경한다! 범인 추격보다 다중 밀집 구역 격리선 및 대피로 확보가 1순위다! 주요 교차로 통제하고 대피 동선 분산 유도해!”*
상부 국정위기관리센터 직통 라인이 연결된다.
위기관리수석:** “청장, 이거 전국 단위 조직적 테러로 판단합니까? 계엄이나 군 투입 검토해야 합니까?”
**경찰본청 지휘관 (입술을 적시며):** “전국 동시다발적 양상인 것은 맞습니다. 추가 발생 가능성도 배제할 수 없습니다. 다만… 아직 배후나 지휘 계통이 전혀 잡히지 않았습니다.”
확정도, 부정도 하지 않는다. 그 회색 지대가 지휘관의 어깨를 짓누르는 가장 무거운 추다.
**21:15 ~ 21:44 [경찰특공대 KNP SWAT]****일반 순찰대가 거리의 혼란을 봉합하는 동안, 특공대는 ‘최악의 시나리오’를 상정하고 움직이는 사람들이다.
21:22**, 장갑차 내부는 숨소리조차 들리지 않을 만큼 조용하다. 기도 비닉을 위해 사이렌도 껐다.
**특공대 팀장 (전술 무전):** “상황실, 목표 건물 내부에 사제 폭발물이나 총기 보유 정황 있는가?”
**상황실:** “확인 안 됨. 인질극 전환 가능성 염두에 두고 진입할 것.”
‘확인 안 됨’은 ‘없음’과 전혀 다른 단어다.**21:36**, 복합상가 후문 진입. 정전으로 비상등만 깜빡이는 계단은 짙은 연기로 어둡다. 코너 전환, 문 앞 정지, 손가락 두 개로 보내는 무음 수신호. 포인트맨이 문을 걷어찬다.**21:39**, 2층 복도 끝에서 인질의 목에 흉기를 들이댄 남자를 확인한다. 거리 10미터. 레이저 표적 지시기가 남자의 미간에 붉은 점을 찍는다.
**포인트맨:** “경찰특공대다! 무기 버려! 손에서 놓아!”
짧은 대치. 남자의 팔 근육이 수축하며 칼끝이 안으로 파고드는 찰나— 위협이 명확하다.***탕! 탕!*
짧고 건조한 더블 탭(Double Tap) 두 발. 복도가 거짓말처럼 조용해진다.
포인트맨:** “용의자 무력화 완료. 인질 확보. 2층 구역 클리어.”
그러나 ‘클리어’는 그 건물 2층 복도뿐이었다. 창밖의 대한민국은 아직 아무것도 클리어되지 않았다.
**22:22 ~ 23:10 [경찰 지휘본부]****군 통합작전본부와의 화상 협조 회의. 화면 너머 군 장성의 입에서 *“전군 최고 경계태세 격상 및 수도권 주요 거점 방호 병력 투입 검토”*라는 단어가 나온다. 무장 병력이 도심에 들어서는 순간, 대한민국은 평시 헌정 체제에서 준전시 상태로 넘어간다.
경찰본청 지휘관:** “군 병력이 장갑차 끌고 도심 번화가에 들어오는 순간, 시민 패닉은 지금의 열 배가 됩니다. 외신에는 내전이나 계엄으로 비칩니다. 현 단계에서는 경찰력으로 통제 가능합니다. 군은 외곽 핵심 기반시설 차단선만 맡아주십시오.”
확신이 아니라 처절한 의지다.**23:10**, 전국 현장 사살 보고 1차 공식 집계 완료. ‘정당방위 및 물리력 행사 기준 충족.’ 공문서 한 줄로 정리된 그 문장 뒤에는, 방아쇠를 당긴 대원들의 영원히 지워지지 않을 기억이 매달려 있었다.
🎙️ **30년 후 특공대원 인터뷰:** *“사살 순간은 어제 일처럼 또렷합니다. 그런데 이상하게 감정보다는 몸의 감각만 먼저 기억납니다. 방아쇠의 2단 압력, 어깨를 치는 소총 반동, 탄피 냄새, 그리고 다음 방으로 넘어가던 발걸음. 그날 밤 우리는 서울 한복판에서 전쟁을 치렀습니다.”*
🎙️ **30년 후 경찰 지휘관 인터뷰:** *“국가는 강하고 빠르게 움직일수록 안전해 보이지만, 공권력이 선을 넘는 순간 다시는 평시로 돌아올 수 없습니다. 조준 사격을 어디까지 허용할 것인지, 군의 도심 진입을 어디서 막을 것인지. 결국 우리는 국가가 쓸 수 있는 가장 극단적인 폭력 바로 한 걸음 앞에서 브레이크를 밟았습니다.”*
거리의 망설임은 개인의 양심이었고, 지휘본부의 결단은 제도의 책임이었다. 총을 쏘는 것과, 쏠 수 있도록 허용하는 것은 다르다.
**※ 중간 안내: 본 글은 가상의 위기 대응 기록 형식을 빌려 재구성한 모큐멘터리(가상 다큐멘터리) 창작 픽션이며, 등장하는 군·경찰의 작전 기록과 구술 녹취록은 모두 허구입니다.**
## 3. “상병님, 이거 북한 아닙니까” (현장 병사 시점)
**21:35 ~ 21:50 [수도권 외곽 보병대대 생활관]****“상병님… 이거 진짜 북한 소행 아닙니까?”
생활관 TV 앞에서 말이 먼저 튀어나왔다. 화면 하단에서는 시뻘건 특보 자막이 쉴 새 없이 롤링되고 있었다. `전국 동시다발 흉기·방화`, `발생 지점 60곳 돌파`. 지도에 찍힌 붉은 점들이 전염병처럼 번져 나갔다. 방탄복 끈을 조이던 선임 상병이 TV에서 눈을 떼고 나를 한 번 날카롭게 쳐다봤다.
상병:** “야. 주둥이 함부로 놀리지 마라. 위에서 아직 아무 말 없잖아.”
**일병:** “아니, 근데 생각해보십시오. 금요일 밤 8시 42분에 전국에서 동시에 저렇게 터지는 게… 간첩이나 특수부대 아니면 말이 안 되잖습니까.”
**상병 (낮게 씹어 뱉듯):** “…나도 몰라, 임마. 아무도 모른다고, 지금.”
목소리는 내리깔았지만 상병의 눈동자도 흔들리고 있었다. 그가 K2 소총의 노리쇠를 당겼다 놓으며 빈 약실을 확인하더니, 지급받은 탄창을 뺐다 다시 세게 밀어 넣었다. *철컥.* 쇳소리가 유난히 크게 생활관을 울렸다. 내 손도 괜히 단독군장 탄입대를 만지작거렸다. 방금 확인했는데 또 확인했다.
**21:52 ~ 22:05****대대 지휘통제실 스피커에서 비상이 터졌다.
*“전 부대 최고 경계태세 돌입. 국지도발 대비태세 및 후방 국가중요시설 방호 출동 준비. 탄약고 개방, 출동 병력 전원 실탄 불출.”*
행정반 앞 복도의 공기가 단숨에 얼어붙었다. 옆 분대 동기 녀석이 마른침을 삼키며 중얼거렸다.
*“와… 야, 이거 훈련 아니지? 진짜 큰 거 터진 거 아냐?”*
탄약반장이 철제 탄통의 납 봉인을 펜치로 끊어냈다. 노란 공포탄이 아니었다. 구릿빛 탄두가 서늘하게 빛나는 5.56밀리 보통탄(실탄) 30발들이 클립이 손바닥 위에 묵직하게 떨어졌다. 손끝이 미세하게 떨려 탄창에 클립이 한 번에 물리지 않았다. 옆에 서 있던 상병이 내 팔꿈치를 툭 쳤다.
상병:** “야, 손 떨지 마. 숨 크게 쉬어. 장난 아니다, 정신 똑바로 차려.”
말은 그렇게 하면서도, 상병 역시 방탄 헬멧 턱끈을 두 번이나 고쳐 매고 있었다.
**22:18 ~ 03:40 [수도권 외곽 변전소 및 도심 차단선 초소]****위장막을 걷어낸 육군 트럭 열 대가 일제히 부대 정문을 빠져나갔다. 도심 경계선으로 진입할수록 네온사인과 아파트 불빛이 빽빽해졌다. 보도에 멈춰 선 시민들이 군용 트럭 행렬을 보며 휴대전화 카메라를 들이댔다. 포성만 없을 뿐, 풍경은 이미 전쟁이었다.
적재함 구석에서 후임 하나가 기어들어 가는 목소리로 또 물었다.
막내 이병:** “상병님… 만약 진짜 북한군 침투면 우리 오늘 밤에 바로 교전 들어가는 겁니까?”
**상병 (신경질적으로 방탄모를 고쳐 쓰며):** “야, 그만 좀 물어봐! 북한이면 차라리 낫지, 임마! 북한 아니면 뭐겠냐? 응? 지금 적이 군복 입고 내려온 것도 아니고, 사복 입은 미친놈들인지 간첩인지 위에서도 확정이 안 났다잖아!”
확정이 안 났다는 건, 적이 아니라는 뜻도 아니고 적이라는 뜻도 아니었다. 그 모호함이 총구보다 더 무서웠다.**새벽 2시경, 안개 낀 변전소 외곽 도로 저편에서 헤드라이트를 켠 검은색 승용차 한 대가 속도를 줄이지 않고 차단선 쪽으로 접근했다. 순간 심장이 쿵 하고 갈비뼈를 쳤다. ‘혹시.’
일병 (소총 개머리판을 어깨에 견착하며):** “상병님! 차 옵니다! 정지선 안 멈추는데요?! 수하합니까?! 노리쇠 당길까요?!”
**상병 (내 총열 덮개를 손바닥으로 지그시 누르며 낮게 다그침):** “야, 흥분하지 마! 방아쇠 울에서 손가락 빼! 내가 쏘라고 하기 전엔 절대 방아쇠에 손 걸지 마라! 민간인일 수도 있어!”
**상병 (경광봉을 강하게 흔들며 앞으로 반 발짝 나서서 고함):** “정지! 정지하십시오! 군 작전 구역입니다! 우회하십시오!”
승용차가 바리케이드 10미터 앞에서 끼익 소리를 내며 멈추더니, 비상등을 깜빡이며 천천히 유턴해 어둠 속으로 사라졌다. 그제야 내 검지가 방아쇠 울 안쪽에 쥐가 날 만큼 깊숙이 들어가 있었다는 걸 깨달았다. 방탄복 등줄기 아래로 식은땀이 주르륵 흘러내렸다.
## 4. 작전통제실 22시 11분, 그리고 “그때 나 진짜 무서웠다”
**22:11 ~ 23:12 [군 통합작전본부 지하 지휘통제실]****초소의 스무 살 병사가 “방아쇠를 당기지 않는 긴장” 속에 서 있었다면, 지하 벙커의 지휘관은 “군대를 어디까지 움직일 것인가”를 결정해야 하는 사람이었다. 전시 작전권과 평시 헌정 질서 사이, 그 아슬아슬한 경계선을 넘을지 말지를 피 말리게 계산하는 시간이었다.
안보실장 (화상 연결):** “의장님, 지금 경찰력만으로는 수도권 주요 역사와 다중 밀집 지역 통제가 한계입니다. 현 단계에서 계엄에 준하는 군 병력 도심 직접 투입, 어떻게 보십니까?”
**군 지휘관 (단호하고 낮은 어조로):** “후방 국가중요시설—발전소, 통신 기지국, 정수장 외곽 경계 강화는 지금 즉시 가능합니다. 그러나 무장 병력의 도심 시가지 직접 투입은 경찰 통제선이 완전히 붕괴되었을 때만 검토하는 것이 타당합니다.”
**정보본부장:** “휴전선 이북 포병 진지 및 기계화부대 기동 징후 전무합니다. 평양 방송이나 대남 교신망에도 특이 트래픽이 전혀 안 잡힙니다.”
**작전참모:** “안전당국과 일부 지자체에서 도심 혼란 진압을 위해 대테러 부대 외 일반 보병 대대 투입을 비공식 타진해 왔습니다.”
**군 지휘관:** “거절해. 소총 든 일반 보병이 패닉에 빠진 민간인 군중과 마주 서는 순간, 통제가 아니라 참사가 난다. 군이 도심에 들어가면 경찰 지휘권이 무력화되고 명령 체계가 두 개로 쪼개져.”
결론은 단 한 줄의 지침으로 하달되었다.
**“도심 치안은 경찰 우선. 군은 외곽 차단선 밖을 절대 넘지 말 것.”**
그 보이지 않는 선이 그날 밤 대한민국의 헌정 질서를 지킨 마지노선이었다.
**30년 후 — 병사와 군의 기록**
🎙️ **당시 초소 경계병 (당시 20세 일병, 현재 50세):** “그때요? 솔직히 말하면… 그때 나 진짜 무서웠습니다.”
인터뷰 카메라 앞에서 반백이 된 중년의 남자가 머쓱하게 웃으며 말했지만, 그 웃음은 금세 사라졌다.
🎙️ **당시 초소 경계병:** “지금이니까 이렇게 웃으면서 말하죠. 그날 밤엔 진짜 전쟁 나는 줄 알았습니다. 우리가 훈련소에서 배운 전쟁은 적이 명확히 정해져 있잖습니까. 휴전선 북쪽에서 군복 입고 내려오는 적군. 그런데 그날 밤은 적이 안 보였어요. 사방이 아파트 불빛이고 네온사인인데, 어디서 누가 칼을 들고 튀어나올지, 저기서 굴러오는 민간 승용차가 폭탄을 싣고 오는 건지 알 수가 없으니까… 눈에 보이지 않는다는 게 총알보다 훨씬 더 무섭더라고요.
결과적으로 우리 부대는 그날 밤 아무 일도 안 했습니다. 총 한 발 안 쐈고, 범인이랑 대치도 안 했고, 그냥 해 뜰 때까지 아스팔트 위에서 떨면서 서 있다가 복귀했어요. 작전본부 지하 벙커에 계셨던 장군님들은 아마 침착하게 고도의 전략적 판단을 하셨을 겁니다. 하지만 현장에 서 있던 저는 아니었어요. 그날 밤, 나 진짜 오금이 저릴 만큼 무서웠다니까요. 근데… 그게 부끄러운 일은 아니잖습니까. 그때 저나 내 옆의 동기들이나, 이제 갓 스무 살짜리 애들이었는데.
근데 제일 기묘했던 건, 일주일 뒤에 정부에서 ‘외부 세력 개입 확정 불가’, 사실상 북한 소행이라는 증거가 없다고 발표했을 때였습니다. 전쟁 안 난다니까 안심이 돼야 하는데, 안심이 아니라 등골이 더 서늘해졌어요. ‘그럼 대체 뭐냐고. 적이 밖에서 온 게 아니면, 그날 밤 우리는 대체 누구한테 총구를 겨누고 서 있었던 거냐고.’ 그 질문이 제대하고 삼십 년이 흐른 지금까지도 안 지워집니다.”
사건이 수습된 이듬해, 대한민국 국군의 작전 교범 제1장에는 짧은 문장 하나가 새로 추가되었다.
**`“비군사적·초국가적 동시다발 복합 위기 상황 발생 시, 군의 후방 핵심 기반시설 방호 및 민간 치안 외곽 지원 역할을 강화한다.”`**
군사학교 강의실에서 교관은 생도들에게 분필로 칠판을 두드리며 말했다.***“기억해라. 이제 우리가 상대할 적은 한 방향에서만 오지 않는다.”*
그날 밤, 지휘관은 ‘확정되지 않은 적’을 향해 섣불리 군대를 움직이지 않았고, 스무 살 병사는 ‘확정되지 않은 공포’ 속에서 끝내 방아쇠를 당기지 않았다. 그 아슬아슬한 절제가 대한민국이라는 조직을 파국에서 구했다. 그러나 그날 이후 우리가 경계해야 할 방향은 영원히 바뀌었다. 적은 휴전선 너머의 특정한 좌표가 아니라, 언제든 다시 도래할 수 있는 ‘가능성’ 그 자체가 되었다.
*(4부에서 계속)*
#### 📂 모큐멘터리 5부작 《확정 불가 ― 어느 밤과 그 이후 30년의 기록》 연재 목차
사건 최초 발생 시각인 매일 저녁 20시 42분**에 순차 공개됩니다.
- [1부. 프롤로그 : 준비와 대비의 간극, 그리고 20시 42분](https://mixedlog.com/archives/2175) (11/09 20:42 공개)
- [2부. 생존의 계산 : 연기의 복도와 검은 태그, 그리고 30년 뒤의 눈물](https://mixedlog.com/archives/2176) (11/10 20:42 공개)
- ▶ 현재글 3부. 물리력의 경계 : 당기지 못한 방아쇠와 스무 살 병사의 실탄
- [4부. 확정 불가와 의심 : 지하 회의실의 붉은 펜과 1도의 균열](https://mixedlog.com/archives/2178) (11/12 20:42 공개)
- [5부(완결). 번호에서 이름으로 : 안치소의 번호표와 삭제된 백서, 그리고 30년 후](https://mixedlog.com/archives/2179) (11/13 20:42 공개)
---
# [모큐멘터리 픽션] 확정 불가 (2/5) ― 생존의 계산 : 연기의 복도와 검은 태그, 그리고 30년 뒤의 눈물
*Published on 2026-11-10 by | Category: 창작*
**URL**: https://mixedlog.com/archives/2176
---
⚠️ [창작 모큐멘터리(가상 다큐멘터리) 픽션 안내 — FICTION DISCLAIMER]
• 본 연재물(**《확정 불가 ― 어느 밤과 그 이후 30년의 기록》, 전 5부작 중 제2부**)은 가상의 복합 위기 상황과 그 이후 30년의 기억을 다큐멘터리 백서·구술 녹취록 형식으로 재구성한 **순수 창작 픽션(Fiction)**입니다.
• 본문에 등장하는 모든 사건, 일시, 국가기관 명칭, 공문서 번호, 뉴스 속보, 재난문자 및 통계 수치는 **문학적인 연출을 위해 창작된 허구**이며, 실제 사건이나 실존 인물·기관의 공식 기록과 일절 무관합니다.
## 1. 백서 기록 : ‘전원 구조 불가능’과 가동률 198% (30년 후 실무관 구술)
🎙️ **기록원 조사관:** “사건 발생 30분 시점에 국가의 대응 기조가 ‘구조’에서 ‘관리’로 전환되었다고 말씀하셨습니다. 그 판단은 누가 내렸습니까?”
🎙️ **전직 위기관리센터 실무관:** “공식적으로는 중앙대책본부의 집단 결정이었습니다. 그러나 비공식적으로는… 현장의 숫자였습니다.
첫 신고 후 30분 무렵, 우리는 판단을 바꿨습니다. **‘전원 구조는 물리적으로 불가능하다.’**
지하 상황실에서 이 문장을 처음 입 밖으로 꺼내기까지 무거운 침묵이 흘렀습니다. 그러나 그 한마디가 제 인생을 바꿨습니다. 동시다발, 다지점, 다수 사상. 소방차도, 구급차도, 응급실 병상도 물리적으로 부족하다는 계산이 나왔습니다. 그 순간부터 우리는 모든 생명을 구하는 국가가 아니라, ‘최대 다수의 생존율’을 계산해 선택하는 국가가 되었습니다. 이 표현은 공식 백서에 없습니다.
T+52분(21:34), 중앙대책본부에서 비상 의료 분류 기준 상향(전시 대량재해 트리아지 적용) 지침이 선제 승인되었습니다. 내부에서도 ‘윤리적·정치적 후폭풍이 감당할 수 없을 만큼 크다’는 반대가 있었습니다. 그러나 밤 11시를 넘기며 상황실에 보고된 수도권 응급실 평균 가동률은 실제로 **198%**까지 치솟았습니다.
수치는 모든 윤리적 토론을 끝냅니다. 적어도 그 순간에는요. 우리는 공문서에 ‘치료 포기’라는 단어 대신 ‘의료 자원의 전략적 집중’이라는 행정 용어를 썼습니다.”
## 2. 상황실의 지도 & 2층 복도의 선택 (119 상황실과 현장 소방관)
**20:42 ~ 20:49 [119 종합상황실]****첫 신고가 접수된다. 전면 상황판 지도에 작은 붉은 점 하나가 찍힌다. 금요일 밤의 흔한 출동 표시다.
그러나 7분 만에 붉은 점이 다섯 개로 불어난다. 상황실 내 80개 수보대(신고 접수석)의 적색 램프가 일제히 점멸하며 전화벨이 비명처럼 겹친다.
수보 요원 1:** “○○구 상가 연기 다량 발생! 요구조자 최소 10명 이상!”
**수보 요원 2:** “■■구에서도 동일 양상 신고입니다! 복도에 사람이 쓰러져 있대요!”
**상황팀장:** “뭐야, 왜 동시에 이래? 관할 서 펌프차, 구급차 전부 빼! 회선 왜 이렇게 밀려!”
**통제요원:** “팀장님, 지금 대기 콜만 70통 넘었습니다! 신고 폭주합니다!”
**21:03 ~ 21:08 [FIELD — 현장 소방관]****무전이 두 번 울렸다. 처음에는 단순 쓰레기통 화재. 두 번째는 “다수 사상자 발생 가능성, 전 대원 공기호흡기 완착”. 금요일 밤이었고, 이미 주취자 구급 출동 한 건을 처리하고 귀소하던 길이었다.
*“펌프 1호, 복귀 취소! 지금 즉시 ○○사거리 복합상가로 기수 돌려! 코드 제로!”*
현장 도착. 검은 연기가 건물 외벽 환기구를 타고 구렁이처럼 뿜어져 나오고 있었다. 건물 안에서 들려오는 비명은 구체적이지 않다. 누구의 목소리인지 구분되지 않는, 거대한 한 덩어리의 쇳소리다. 수관을 끌고 역류하는 인파를 거슬러 진입한다. 불길보다 유독가스와 패닉이 문제였다.
21:10 ~ 21:14 [119 종합상황실]****지도에 점이 열다섯 개로 늘어난다. 상황실장이 팔짱을 낀 채 처음으로 중얼거린다. “이거… 사고가 아니다. 이상하다.”
신고 접수 대기 120통. 가장 가까운 관할 센터, 남은 예비 펌프차, 구급차 이동 동선. 배치는 본래 냉정한 산수(算數)다. 그러나 계산은 지도의 붉은 점이 늘어날수록 무력해진다.
21:17 [FIELD — 현장 소방관]****건물 2층 복도 끝. 시야 거리 50센티미터 미만의 농연(濃煙) 속에서 쓰러진 두 명을 발견한다. 열화상 카메라에 잡힌 두 개의 실루엣. 왼쪽 남자는 허벅지를 부여잡고 가쁘게 기침하며 몸부림친다. 오른쪽 여자는 미동이 없다.
후임 대원 (면체 마이크 너머로 거친 숨소리):** “팀장님! 두 명인데 들것 하나뿐입니다! 밑에 통로가 막혀서 두 명 동시에 못 업어요! 누구부터 뺍니까!”
**현장 소방관:** “좌측! 숨 쉬는 사람부터 들어! 우측은 동공 반응 없어, 지금 심폐소생술 할 공간 안 나온다! 좌측 먼저 들고 뛰어!”
**후임 대원:** “팀장님, 그래도 아직 몸이 따뜻한데—”
**현장 소방관 (고함):** “명령이야! 둘 다 죽일 거야?! 살아있는 쪽 먼저 잡는다, 들어!”
누가 먼저인가. 재난 매뉴얼과 훈련은 잔인할 만큼 명확하다. 생존 가능성이 높은 쪽부터. 나는 움직이는 사람의 겨드랑이에 팔을 넣는다.**찰나의 선택이었다. 그러나 그 기억은 30년을 남았다.
21:18 ~ 21:42 [FIELD & 119 종합상황실]****무전이 동시에 세 채널에서 찢어질 듯 울린다.
*“여기는 ○○ 선착대! 내부 요구조자 다수, 구급차 최소 10대 추가 지원 바람!”*
*“내부 비상통로 병목 발생! 연기 유입으로 질식 환자 다수, 진입로가 막혀 들것이 못 들어갑니다!”*
신고 대기 200통 돌파. 수보 요원이 눈물을 훔치며 수화기에 소리친다. *“선생님, 젖은 수건으로 코 막으시고 대피 유도등 따라 옥상으로— 여보세요? 여보세요?!”* 뚜— 뚜— 뚜—. 통화 종료. 녹취 서버에 로그는 남지만, 목소리의 주인은 남지 않는다.
불길은 20분 만에 잡혔다. 그러나 정전된 대피 통로마다 미처 빠져나가지 못한 채 유독가스를 마시고 쓰러진 사람들이 가득했다. 이날의 진짜 위협은 화염 자체보다 공포 속의 대피 병목이었다.
같은 시각 상황실. 구급상황관리센터 지도의사의 긴급 의료지도를 받은 실장이 마이크를 쥐고 비장하게 하달한다.
상황실장:** “전 현장 구급대 및 구조대 들어라. 중앙대책본부 전시 트리아지 지침 및 지도의사 승인 사항이다. 현 시각부로 다수 사상 현장의 개별 무호흡·무맥박 심정지 환자 소생술을 유보한다. 호흡이 남아 있는 생존자 이송 및 대피로 확보로 우선순위 전면 조정한다.”
자원은 무한하지 않다. 죽어가는 한 명에게 매달리는 동안 살아있는 열 명이 질식한다. 그러나 그 냉혹한 문장은 현장의 대원들에게 평생 지워지지 않는 부채로 남는다.
🎙️ **30년 후 상황실 근무자 인터뷰:** *“그날 우리는 불을 본 게 아닙니다. 지도를 봤습니다. 점이 10개일 때는 전산 오류인 줄 알았고, 30개일 때는 비상벨을 눌렀고, 60개가 넘어가자… 그때 알았습니다. 국가가 상황을 통제하는 게 아니라, 사건의 뒤꽁무니를 허덕이며 쫓아가고 있다는 걸요.”*
🎙️ **30년 후 소방관 인터뷰:** *“그날, 우리는 최선을 다했습니다. 그건 분명합니다. 그러나 2층 복도 끝에 남겨두고 온 그 여자의 얼굴은 30년이 지난 지금도 선명합니다. 훈련 교범대로 한 선택이었습니다. 살릴 수 있는 사람을 살렸으니까요. 그래도… 가끔은 꿈에서 그 연기 자욱한 복도를 다시 걸어 들어갑니다. 그때 내가 들것 대신 등에라도 업었으면 어땠을까 하고요.”*
**※ 중간 안내: 본 글은 가상의 위기 대응 기록 형식을 빌려 재구성한 모큐멘터리(가상 다큐멘터리) 창작 픽션이며, 등장하는 현장 교신과 의료 기록은 모두 허구입니다.**
## 3. 사이렌이 멈추지 않던 밤과 응급실의 검은 태그 (의료진과 간호사)
**20:55 ~ 22:30 [사이렌이 멈추지 않던 밤]****서울 시내 주요 간선도로. 동쪽에서 울리던 119 구급차 사이렌 소리가 사거리 한복판에서 서쪽에서 달려오는 경찰 싸이카의 사이렌과 날카롭게 교차했다. 부산에서는 빽빽한 고층 빌딩 숲 사이로 소리가 부딪치며 기괴한 공명(共鳴)을 일으켰다. 이중창을 굳게 닫고 커튼을 쳐도 그 소리는 유리창을 떨며 거실 안으로 스며들었다.
대학병원 응급실 앞. 구급차 한 대의 사이렌이 멈추면, 숨을 고를 틈도 없이 저 멀리서 또 다른 사이렌이 꼬리를 물고 이어진다. 도시 전체가 거대한 불규칙 맥박처럼 쿵쾅거렸다. 밤 10시 30분경부터, 사이렌은 더 이상 긴급 신호가 아니라 밤공기의 배경음(Background Noise)이 되었다. 처음엔 심장을 철렁하게 하는 공포였고, 그다음엔 대피하라는 경고였으며, 자정이 가까워지자 끝나지 않는 이명(耳鳴) 같은 지속음이 되었다.
🎙️ 30년 후 기록:** 어떤 유족은 말한다. *“저는 30년이 지난 지금도 길에서 구급차 소리만 들리면 그 자리에 주저앉아 귀를 막습니다.”* 반면 어떤 전직 재난 상황실 실무관은 말한다. *“그날 이후로 사이렌 소리를 들어도 심장이 뛰지 않습니다. 그냥 ‘아, 어디선가 또 업무가 시작됐구나’ 하는 신호로만 들립니다.”* 같은 소리, 너무나 다른 상흔. 그날 밤의 사이렌은 도시가 피 흘리고 있다는 비명이자, 국가 시스템이 한계치를 넘어 과열되었다는 경고음이었다.
**22:17 ~ 22:40 [권역응급의료센터 입구]**
응급실 센서 자동문이 채 닫히기도 전에 피 묻은 다음 스트레처(들것)가 문을 거칠게 밀고 들어온다. 리놀륨 바닥에는 빗물인지, 생리식염수인지, 환자의 혈액인지 구분되지 않는 검붉은 발자국이 수백 겹으로 짓이겨져 있다.
응급실 자동문을 경계로 세상은 두 구역으로 갈라진다. 문 안쪽은 촌각을 다투며 생사를 가르는 의료진의 전쟁터, 문 바깥은 피 마르는 침묵으로 이름을 기다리는 가족들의 수용소.
출입문 옆 흰 벽에 청테이프로 급히 붙인 A4 용지 안내문이 구겨져 있다.
`〈응급실 내부 진입 절대 불가 — 보호자 대기 구역은 외부 주차장 임시 천막으로 이동 바랍니다〉`
플라스틱 의자는 일찌감치 동났다. 차가운 병원 로비 바닥에 주저앉아 휴대폰만 붙잡고 오열하는 사람들의 그림자가 길게 늘어진다.
**23:12 ~ 23:47 [응급실 내부 — 중증도 분류(Triage) 구역]**
밖은 후텁지근한 초여름 밤이지만, 응급실 안의 공기는 소름이 돋을 만큼 차갑다. 수도권 응급실 평균 병상 가동률 198%. 이미 침상은 물론 바닥에 깔아놓은 매트리스까지 포화 상태다. 당직 응급의학과 전문의가 복도 한복판에서 피 묻은 장갑을 낀 손으로 소리친다.
🎙️ **수간호사:** “교수님! ○○구 복합상가 화재 현장에서 구급차 넉 대 동시에 더 들어왔습니다! 중환자실(ICU)도 꽉 찼고 인공호흡기(Ventilator) 라인도 이제 한 개밖에 안 남았어요! 원내도 평시 기준으로는 더 못 버팁니다!”
🎙️ **당직 전문의:** “평시 매뉴얼 접어! 중앙대책본부 승인 떨어진 전시 대량재해 트리아지(START) 기준, 지금부터 우리 응급실 원내에도 전면 적용한다! 자발 호흡 여부, 요골동맥 맥박, 의식 반응 딱 세 개만 봐! 지체 없이 바로 분류해!”
🎙️ **년차 낮은 전공의 (심폐소생술을 하며 울먹이는 목소리로):** “교수님, 이 20대 남자 환자분 방금 심정지 왔습니다! 에피네프린 한 번만 더 치고 제세동기—”
🎙️ **당직 전문의 (전공의의 팔을 단호하게 잡아채며):** “스톱! 손 떼! 이송 중에 이미 무산소성 뇌손상 15분 넘었어! 지금 그 환자 한 명한테 전공의 둘이랑 간호사 매달려 있으면 저기 입구에서 들어오는 기흉(Pneumothorax) 환자 세 명이 숨 막혀 죽는다! 손 떼고 사망 선언해, 빨리!”
🎙️ **전공의:** “교수님, 그래도 아직 스물두 살인데 어떻게 그냥—”
🎙️ **당직 전문의 (핏발 선 눈으로 고함):** “우리가 지금 착한 의사 노릇 할 시간 없어! 살릴 수 있는 확률 50% 이상인 적색(Red) 환자한테만 산소랑 혈액 몰아줘! 당장 옆 베드로 이동해!”
스트레처 세 개가 동시에 복도를 밀고 들어온다. 망설일 틈조차 없다. 심전도 모니터의 날카로운 경고음이 사방에서 불협화음으로 겹친다. *삑— 삑— 삐이이이—***구석 베드 모니터의 초록색 파형이 마침내 수평 직선을 그린다. 짧은 정적조차 허락되지 않는다.
*“사망 시각 23시 47분. 베드 비워!”*
차트에 시각은 남는다. 의료진의 표정은 남지 않는다.
00:03 [검은 태그 (Black Tag)]****응급실 복도 끝 철제 카트 위에, 평소에는 먼지가 쌓여 있던 ‘검은색 분류 태그(Black Tag: 사망 또는 소생 가망 없음)’ 묶음이 풀려 있다.
트리아지 간호사 (손목 맥박을 짚은 채 떨리는 목소리로):** “선생님… 이분, 상가 대피 통로에서 연기 흡입하고 쓰러지신 분인데… 아직 미세하게 동공 반사 남아 있어요. 호흡이 분당 4회로 떨어지긴 했는데… 적색(최우선 치료) 태그 달까요?”
**당직 전문의 (환자의 청색증이 온 얼굴과 산소포화도 수치를 내려다본다):** “…중증 흡입 화상에 양측 기흉이야. 지금 수술실 세 곳 다 열려 있고 대기 중인 적색 환자만 열두 명이다. 기관삽관 튜브도 없어.”
**트리아지 간호사:** “선생님, 그래도 아직 숨이 붙어 있는데 검은색을 어떻게 달아요…!”
**당직 전문의 (잠시 눈을 질끈 감았다가 뜨며, 낮고 메마른 목소리로):** “…모르핀 소량 투여하고 복도 끝 격리 구역으로 빼. 흑색(Black) 달아라. 내가 달겠다.”
전문의를 스쳐 지나가며 바깥 자동문 틈으로 구급대원의 외침이 들려온다. *“임산부입니다! 의식 있어요! 길 비켜주세요!”***의사는 주저하던 손으로 묵묵히 검은색 종이 태그를 뽑아 환자의 손목에 묶는다. 매듭 하나를 묶는 짧은 순간이었으나, 살아있는 사람에게 죽음의 번호표를 먼저 달아주었다는 그 죄책감의 무게는 30년이 지나도 덜어지지 않는다.
00:12 ~ 02:07 [응급실 내부 — 간호사 시점]****벽시계를 올려다볼 틈조차 없다. 시간은 오직 바이탈 모니터의 숫자로만 흐른다. 혈압 82/50, 맥박 138, 산소포화도(SpO2) 84%. 사람이 먼저 보이지 않고 숫자가 먼저 보이며, 그다음에야 피 묻은 얼굴이 보인다.
가위로 그을린 셔츠를 잘라낸다.
*“환자분, 성함이 어떻게 되세요?! 내 말 들려요?!”*
신음 소리뿐, 대답이 없다. 신분증도 없다. 나는 유성 매직 뚜껑을 입으로 물어 뽑고 환자의 창백한 팔목 안쪽에 굵은 글씨로 임시 번호를 적는다. `《남-미상-042》`. 그날 밤, 그 차가운 일련번호가 한 인간의 삶 전체를 대신하는 시간이 있었다.
00:27**, 복도 간이침대에 누운 열일곱 살 남짓한 여자아이가 피 묻은 손으로 내 간호복 소매를 있는 힘껏 붙잡는다.
**소녀 환자 (산소마스크 너머로 가쁜 숨을 몰아쉬며):** “언니… 언니, 제발 우리 엄마한테 연락 한 번만… 주머니에 내 폰이 깨져서 안 켜져요… 엄마가 나 독서실 있는 줄 알고 찾으러 나왔을 텐데… 전화 한 통만 해주세요, 네?”
**간호사 (소녀의 손등을 감싸 쥐며, 눈물이 고이는 것을 참으려 입술을 깨문다):** “학생, 말하면 숨차요. 산소 수치 떨어져. 지금 수액 맞고 있으니까 조금만, 진짜 조금만 기다려요. 내가 이따가 꼭 걸어줄게.”
**소녀 환자:** “언니, 우리 엄마… 번호가 010…”
**선임 간호사 (뒤에서 다급하게 소리침):** “3번 베드 대동맥 파열 환자 혈압 루트 막혔어! 수혈 팩 들고 지금 당장 이리 와! 빨리!”
아이는 대피 통로에서 휴대전화가 일찌감치 깨진 탓에, 밤 아홉 시가 넘어 바깥 세상의 휴대전화 통신이 통제되었다는 사실조차 모르고 있었다. 지금은 전화를 걸어도 연결되지 않는다는 잔인한 사실을 차마 입 밖으로 꺼낼 수 없었다. 나는 소녀의 손을 반강제로 떼어내고 돌아선다. 대답을 길게 하면 발이 떨어지지 않을 것 같아서. *“조금만 기다리세요.”* 그 말은 위로가 아니었다. 그 자리에서 도망쳐 다음 환자에게 가기 위해 내가 나 자신에게 한 거짓말이었다. 30분 뒤 내가 다시 그 복도 코너로 돌아왔을 때, 소녀의 침대 위에는 흰 시트가 머리 끝까지 덮여 있었고 손목에는 검은 태그가 매달려 있었다.
**01:18**, 원무과 행정팀장이 응급실 입구로 뛰어 내려온다.
**원무팀장:** “과장님! 영안실 안치 냉장고 24구 다 찼습니다! 복도 끝에 가림막 쳐놓은 시신만 벌써 서른 구가 넘어요! 더 이상 수용 불가능합니다, 구급차 돌려보내야 해요!”
**당직 전문의:** “밖에서 피 흘리는 사람을 어디로 돌려보내! 다른 대학병원도 다 똑같아! 지하 세미나실이랑 주차장 천막 터서라도 받아!”
밖에서는 구급차 한 대가 끝내 응급실 진입을 포기하고 후진 기어를 넣는다. 구급대원이 운전석 창문을 치며 절규한다. *“여기도 안 된대! 어디로 가라고, 도대체 어디로 가냐고!”* 그러나 문 안쪽의 우리 역시 이미 바닥에 누워 있는 사람들을 넘어갈 수 없었다.**02:07**, 주사기에 약물을 뽑아 올리던 내 손이 처음으로 주체할 수 없이 덜덜 떨려 앰플을 바닥에 떨어뜨린다. 옆에 있던 선임 간호사가 말없이 내 손목을 꽉 잡아준다.***“숨 쉬어. 괜찮아?”*
괜찮다는 말이 입 밖으로 나오지 않는다. 대신 나는 고개만 세차게 끄덕인다. 괜찮아야만 하니까. 내가 무너지면 저 복도의 숫자들이 전부 0이 되니까.
그날 밤, 우리는 생명을 구하는 천사도 영웅도 아니었다. 단지 확률을 계산하고 자원을 배급하는 냉혹한 심판관들이었다. 누가 살아남을 가능성이 1%라도 더 높은지, 남은 산소통 하나를 누구의 입에 물릴지, 그리고 언제 심폐소생술의 손을 멈출지.
화면 밖에서 국가는 상황이 통제 국면에 들어갔다고 발표했다. 그러나 응급실 자동문 안에서는 인간이 견딜 수 있는 윤리의 한계가 먼저 부서져 내리고 있었다. 그날 밤 이후로, 나는 환자가 들어오면 얼굴을 먼저 보지 않고 손목과 모니터 숫자부터 본다. 이름을 나중에 묻는 것, 그것이 그 밤이 내게 남긴 생존 방식이었다.
## 4. 울지 못한 사람들 (30년 후 — 응급실 간호사 구술 녹취록)
🎙️ 기록원 조사관:** “사건 당시 수도권 권역응급의료센터 당직 간호사로 근무하셨습니다. 그날 밤 현장에서 가장 견디기 힘들었던 순간은 언제였습니까?”
🎙️ **전직 간호사 (당시 27세, 현재 57세):** “힘들다는 생각조차 할 겨를이 없었습니다. 그냥 미친 듯이 바빴습니다. 내 손이 잠시라도 멈추면 바로 옆 스트레처의 환자가 숨이 넘어가니까요. *(짧은 한숨)* 그래도 굳이 꼽자면… 자정 넘어서 복도 끝에서 검은색 태그 상자 봉인을 처음 뜯었을 때였던 것 같습니다. 당직 교수님이 환자 동공을 보시고 말없이 고개를 끄덕이면, 제가 검은색 종이 태그를 뽑아 손목에 묶었습니다. 그날 밤엔 그게 제 업무였습니다.”
🎙️ **기록원 조사관:** “그날 이후 선생님의 삶에서 가장 크게 달라진 점이 있습니까?”
🎙️ **전직 간호사 (당시 27세, 현재 57세):** “유리 자동문 열리는 소리요. 은퇴한 지금도 마트나 병원 자동문이 ‘스르륵’ 하고 열리는 소리를 들으면 심장이 먼저 덜컥 내려앉습니다. 저 문이 열리면 또 피 묻은 들것이 끝없이 밀려 들어올 것 같아서요. 그리고… 손의 감각이요. 그날 새벽 복도에서 열일곱 살쯤 된 아이가 제 간호복 소매를 잡았던 감각이 가끔 어제 일처럼 손등에 그대로 떠오릅니다. *(잠시 침묵)* 깨진 휴대폰을 쥐고 엄마한테 전화 한 통만 해달라고 했습니다. 그런데 제가 ‘숨차니까 조금만 기다리세요, 이따 꼭 걸어줄게요’ 하고 손을 떼어냈거든요.”
🎙️ **기록원 조사관:** “그 환자의 이름을 기억하십니까?”
🎙️ **전직 간호사:** “*(긴 침묵)* 아니요. 끝내 이름도 못 물었습니다. 그날 밤 차트에는 이름 대신 제가 매직으로 적어놓은 임시 번호만 적혔습니다. 그날은 이름을 묻고 가족에게 전화를 걸어주는 게 우선순위가 아니었으니까요. *(호흡이 가빠짐)* 그런데요, 조사관님… 제가 지난 30년 동안 아무한테도 못 한 이야기가 하나 있습니다. 그때 대동맥 파열 환자 쪽으로 뛰어갈 때… 그 아이 손에서 제가 먼저 내 손을 뿌리친 건지, 아니면 그 아이 손에 먼저 힘이 빠진 건지… 그 찰나의 기억이 머릿속에서 하얗게 비어 있습니다.”
🎙️ **기록원 조사관:** “30년이라는 긴 세월이 흘렀습니다. 지금은 그날 밤을 어떻게 받아들이고 계십니까?”
🎙️ **전직 간호사:** “국가는 그날 최선을 다해 버텼다고 생각합니다. 우리 병원도 끝내 무너지지 않았고, 실제로 그날 밤 저희 손으로 백 명 넘는 중상자를 살려냈습니다. *(목소리가 잘게 떨리며 낮아진다)* 그런데… 저는 그날 밤 눈물이 한 방울도 안 나왔습니다. 날이 밝고 집에 돌아가서 그을음 묻은 근무복을 빨면서도 안 울었고, 그다음 날 다시 출근해서도 아무 일 없던 사람처럼 주사를 놓았습니다. 지난 30년 내내 저는 제가 그날을 잘 이겨낸 줄 알았습니다. 내가 참 단단한 사람인 줄 알았어요. *(말을 멈추고 숨을 고른다)* …그런데 오늘 여기 와서 그날 이야기를 입 밖으로 다시 꺼내니까, 이제는 잘 모르겠습니다.”
🎙️ **기록원 조사관:** “선생님, 잠시 쉬었다 진행할까요?”
🎙️ **전직 간호사:** “*(짧게 웃으려다 멈춘다. 눈가에 고인 눈물이 뺨을 타고 흘러내린다)* 아뇨, 괜찮습니다. 그냥… 그 아이가 산소마스크 너머로 ‘엄마한테 전화해 주세요’ 하던 그 쇳소리 섞인 목소리가 30년째 제 귓가에 그대로 남아 있습니다. 제가 결국 그 전화를 못 걸어줬습니다. 그게… 응급실 매뉴얼상 제 역할은 아니었지만… *(말이 끊기고 어깨가 크게 흔들린다)* 한 번도 미안하다고 말을 못 했습니다. 거짓말해서 미안하다고, 혼자 가게 해서 정말 미안하다고… 그 아이한테 사과한 적이 없습니다.”
*(회의실 안의 깊은 침묵. 디지털 녹음기의 작은 붉은 램프만 깜빡인다.)*
🎙️ **전직 간호사:** “*(손등으로 눈물을 닦지 않은 채, 낮고 갈라진 목소리로)* 그날 밤, 우리가 살릴 수 있는 많은 사람들을 살렸다는 사실은 변하지 않습니다. 백서에도 그렇게 적혀 있겠지요. 그런데도… 제 손목을 잡던 그 아이 손가락의 미지근한 온도는 30년이 지나도 식지를 않습니다. *(깊은 숨)* 그날 못 울었던 눈물이… 삼십 년을 돌아서 이제야 조금 늦게 도착한 것 같습니다.”
*(녹음은 구술자 보호 규정에 따라 15분간 일시 중단되었다.)*
*(3부에서 계속)*
#### 📂 모큐멘터리 5부작 《확정 불가 ― 어느 밤과 그 이후 30년의 기록》 연재 목차
사건 최초 발생 시각인 매일 저녁 **20시 42분**에 순차 공개됩니다.
- [1부. 프롤로그 : 준비와 대비의 간극, 그리고 20시 42분](https://mixedlog.com/archives/2175) (11/09 20:42 공개)
- ▶ 현재글 2부. 생존의 계산 : 연기의 복도와 검은 태그, 그리고 30년 뒤의 눈물
- [3부. 물리력의 경계 : 당기지 못한 방아쇠와 스무 살 병사의 실탄](https://mixedlog.com/archives/2177) (11/11 20:42 공개)
- [4부. 확정 불가와 의심 : 지하 회의실의 붉은 펜과 1도의 균열](https://mixedlog.com/archives/2178) (11/12 20:42 공개)
- [5부(완결). 번호에서 이름으로 : 안치소의 번호표와 삭제된 백서, 그리고 30년 후](https://mixedlog.com/archives/2179) (11/13 20:42 공개)
---
# [모큐멘터리 픽션] 확정 불가 (1/5) ― 프롤로그 : 준비와 대비의 간극, 그리고 20시 42분
*Published on 2026-11-09 by | Category: 창작*
**URL**: https://mixedlog.com/archives/2175
---
⚠️ [창작 모큐멘터리(가상 다큐멘터리) 픽션 안내 — FICTION DISCLAIMER]
• 본 연재물(**《확정 불가 ― 어느 밤과 그 이후 30년의 기록》, 전 5부작 중 제1부**)은 가상의 복합 위기 상황과 그 이후 30년의 기억을 다큐멘터리 백서·구술 녹취록 형식으로 재구성한 **순수 창작 픽션(Fiction)**입니다.
• 본문에 등장하는 모든 사건, 일시, 국가기관 명칭, 공문서 번호, 뉴스 속보, 재난문자 및 통계 수치는 **문학적인 연출을 위해 창작된 허구**이며, 실제 사건이나 실존 인물·기관의 공식 기록과 일절 무관합니다.
## 0. 공개 결정문 (사건 30주기 기밀 해제 통보서)
- **문서 번호:** 기록원-제20■■-■■■■호
- **구분:** 일반 공개 전환 (보존 기한 30년 경과)
- **제목:** [확정 불가 ― 어느 밤과 그 이후 30년의 기록] 구술 백서 및 부속 자료 일체
"본 보고서 및 부속 녹취록은 사건 발생 30년 경과에 따라 『공공기록물 관리에 관한 법률』에 의거하여 일반에 공개한다. 단, 국가 안보 및 생존자 개인정보 보호를 위하여 일부 고유명사와 세부 지명은 [○○] 또는 [■■■] 처리되었다."
## 1. 프롤로그 : 기록을 남기는 사람 (사건 30년 후, 구술 인터뷰 도입부)
🎙️ **기록원 조사관:** “녹음 시작되었습니다. 본 인터뷰는 ○○년 ○월 ○○일 발생한 ‘전국 동시다발 복합 위기 사건’ 30주기 공식 구술사 프로젝트의 일환입니다. 선생님께서는 당시 국가위기관리센터 실무 책임자로 근무하셨습니다. 그날 밤의 이야기를 처음부터 들려주실 수 있습니까?”
🎙️ **전직 위기관리센터 실무관:** “녹음은 이미 시작됐습니까? 좋습니다. 중간에 끊지 않으셔도 됩니다. 지난 30년 동안 매일 밤 머릿속에서 지웠다 다시 쓰기를 반복해 온 이야기니까요.
그날은 금요일이었습니다. 사람들이 이 문장을 너무 자주 써서 이제는 진부해졌지만, 정말로 평범한 초여름의 금요일 밤이었습니다. 치안 단계는 ‘정상’, 특이 동향 ‘없음’. 당일 오후 상황 보고서에는 그렇게 적혀 있었습니다.
우리는 준비되어 있다고 믿었습니다. 두꺼운 위기 대응 매뉴얼 바인더도 있었고, 전국 통합 전자상황판도 있었고, 24시간 3교대 당직 체계도 빈틈없이 돌아가고 있었습니다.
그날을 단 한 문장으로 요약하라면 이렇습니다.
**‘우리는 준비되어 있었지만, 대비되어 있지는 않았다.’**
준비(Preparation)는 매뉴얼을 의미합니다. 대비(Readiness)는 상상력입니다. 우리가 평시에 준비했던 위기란 언제나 ‘이상한 사전 징후가 먼저 포착되는 위기’였습니다. 그러나 그날 밤 8시 42분에는 아무런 사전 징후도 없었습니다.
첫 보고는 지극히 일상적인 개별 사건처럼 들어왔습니다. 상업지구 흉기 소란, 복합건물 화재, 다중이용시설 대피 혼잡. 금요일 밤이면 대도시 어딘가에서 늘 발생하는 종류의 사고들이었으니까요. 초기 5분 동안은 솔직히 말해, 상황실의 누구도 사태의 본질을 이해하지 못했습니다. 다만 숫자가 이상하게 많았습니다. 전면 상황판 지도에 붉은 점이 하나둘 늘어나기 시작했습니다. 누군가는 전산망 오류 아니냐고 물었고, 누군가는 서버 과부하를 의심했습니다.
그리고 첫 신고 접수 후 정확히 7분이 지났을 때, 우리는 비로소 ‘전국 동시성’을 인지했습니다. 그 7분이 이후 30년의 역사를 결정한 첫 번째 전환점이었습니다.”
**[기록 삽입 — 초기 대응 타임라인 요약 (30주기 백서 제1장 발췌)]**
• **발생 일시:** ○○년 ○월 ○○일(금) 20:42~ (전국 동시 발생 지점: 최종 103곳)
• **T+00분 (20:42):** 서울 ○○구 상업지구 최초 흉기 난동 신고 및 지방 복합상가 화재 경보 동시 접수
• **T+07분 (20:49):** 상황실 내 ‘다지점 동시다발성’ 최초 인지
• **T+15분 (20:57):** 국가위기관리센터 비상 가동 및 최고 위기 단계 발령
• **T+28분 (21:10):** 대국민 1차 긴급재난문자(CBS) 전국 일괄 발송
• **T+34분 (21:16):** 통화 폭주에 따른 지휘 통신망 확보를 위해 민간 통신 우선권 강제 재배분 명령
## 2. 그날, 첫 한 시간 (초기 시민 혼란과 인지의 붕괴)
○○년 ○월 ○○일, 금요일 밤 8시 42분.**사건은 조용히 시작되었다. 총성이 아니라, 비명으로.
서울의 한 상업지구에서 “칼에 찔렸다”는 첫 112 신고가 접수되고, 같은 시각 지방의 복합상가에서 화재 경보가 울린다.
20:44****인근 지구대 순찰차가 첫 현장으로 출동한다. 거리의 사람들은 아직 상황을 모른다. 누군가는 취객의 소란이라고 생각했고, 누군가는 작은 화재라고 여겼다.
20:47****스마트폰 화면에 지역 커뮤니티 글이 올라온다.
*"여기 칼부림 난 것 같아요."*
*"연기 엄청나요."*
*"경찰 안 오나요?"*
짧고 흔들리는 영상이 공유된다. 비명. 달리는 발소리. 처음에는 믿기 어렵다. 누군가는 합성이라고 말하고, 누군가는 장난이라고 반응한다.
20:50****유사한 영상이 다른 도시에서 올라온다. 같은 시간대, 다른 장소, 비슷한 혼란. 사람들은 그때부터 질문을 바꾼다.
*"이거… 동시에 일어나는 거 아니야?"*
20:52****112와 119는 폭주 상태에 들어간다. 연결 대기 시간이 길어진다. 시민들은 서로에게 전화를 건다. 통화는 연결되지만 끊기기를 반복한다. 메신저 전송이 지연된다. 정보는 완전히 끊기지 않는다. 그러나 확실하게 도달하지도 않는다. 이 ‘불완전한 연결’이 공포를 키운다.
20:55****대형 쇼핑몰에서 안내 방송이 울린다. *"안전을 위해 출입을 제한합니다."* 문이 닫히자 사람들은 더 불안해진다. 밖에 무엇이 있는지 알 수 없기 때문이다. 일부는 문을 두드리고, 일부는 비상구를 향해 몰린다. 혼란은 폭력이 아니라, ‘확인되지 않음’에서 시작된다.
21:02****SNS에는 ‘전국 동시 테러’라는 단어가 등장한다. 그러나 거실의 TV 화면에서는 정각에 시작된 9시 메인 뉴스가 낮에 준비된 평온한 리포트를 차례대로 내보내고 있고, 정부의 공식 발표도 아직 없다. 스마트폰 속의 아비규환과 브라운관의 일상적인 뉴스 사이의 기괴한 괴리가 사람들의 불안을 더욱 증폭시킨다. 확인되지 않은 지도 이미지가 공유된다. 붉은 점들이 표시된 사진. 실제 상황과는 일치하지 않지만, 공포는 지도보다 빠르게 확산된다.
21:10****진행 중이던 9시 뉴스에서 예정된 리포트를 끊고 첫 긴급 속보를 내보낸 직후, 거리와 실내의 휴대전화마다 정부의 첫 긴급재난문자 경보음이 동시에 울린다. 그 순간 부모들은 일제히 자녀에게 전화를 건다. 연결되지 않으면 다시 건다. 계속 건다. 통화 연결음이 길어질수록 상상은 구체화된다. 혼란은 두 방향으로 흐른다. 안으로 숨으려는 사람들과 밖으로 가족을 확인하러 나오는 사람들. 이 교차가 도심을 마비시킨다.
21:16 ~ 21:40****비상 통신 통제로 어렵게 연결되던 휴대전화 통화마저 일제히 끊기며 거리의 고립감이 극에 달한다. 일부 지역에서는 화재 여파로 정전이 발생한다. 사람들은 ‘누가 공격자인지’보다 ‘어디가 안전한지’를 모른다는 사실에 더 흔들린다. 어두워진 실내 다중시설과 비상 통로에서는 급격한 대피 병목으로 2차 부상자가 발생하기 시작한다. 위험을 피하려던 움직임이 새로운 위험을 만든다.
첫 한 시간은 폭력의 시간이 아니라 인지의 붕괴 시간이었다. 사람들은 공격자보다 불확실성과 싸웠다. 그날 밤 대한민국은 물리적 충격보다 먼저 정보 체계의 과부하를 경험했다.
※ 중간 안내: 본 글은 가상의 위기 대응 기록 형식을 빌려 재구성한 모큐멘터리(가상 다큐멘터리) 창작 픽션이며, 등장하는 기관의 보고서와 상황 일지는 모두 허구입니다.**
## 3. 9시 뉴스의 균열 & ON AIR / CONTROL ROOM
**21:08:12 [ON AIR — 사건 발생 26분 후, 9시 메인 뉴스 중 첫 긴급 속보]****[SFX: 진행 중이던 일반 리포트 화면이 끊기며 짧은 속보 알림음 송출]****[자막 하단 크롤 — 가상 뉴스 연출]** `〈긴급속보〉 서울 ○○구 등 도심 상업지구 흉기·화재 신고 다수 접수`
**앵커 (인이어 콜을 받으며 프롬프터 대신 방금 전달된 속보 메모를 내려다본다. 평정 유지):** “진행 중이던 뉴스를 잠시 멈추고 방금 들어온 속보 전해드립니다. 오늘 저녁 8시 42분경부터 서울 ○○구 등 도심 상업지구 여러 곳에서 흉기 사건과 화재가 발생했다는 신고가 잇따라 접수됐습니다. 현재 경찰과 소방당국이 긴급 출동 중이며, 정확한 피해 규모는 아직 확인되지 않았습니다.”
**21:12:03 [ON AIR]****[자막 — 가상 뉴스 연출]** `〈긴급속보〉 부산 ○○동 복합상가에서도 원인 미상 화재… 전국 유사 신고 잇따라`
**앵커 (톤 약간 낮아짐):** “추가 속보입니다. 부산의 복합상가에서도 비슷한 시각 화재와 소란이 발생해 소방당국이 진화 중입니다. 정부는 방금 전 실내 대기를 당부하는 첫 긴급재난문자를 발송했습니다.”
**[그래픽]** 대한민국 지도 우측 상단 작은 점 두 개 표시 (서울, 부산).
**21:17:48 [ON AIR]****[그래픽 전환 — 지도 확대, 붉은 점 6개 표시]**
**앵커 (톤 더 단단해짐):** “지금 보시는 화면은 현재까지 경찰과 소방에 공식 확인된 사건 발생 지점입니다. 서울, 부산, 대전, 광주 등 최소 여섯 곳 이상에서 동시다발적으로 사건이 발생한 것으로 보입니다.” (‘동시다발적’이라는 단어를 처음 사용)
**21:23:40 [ON AIR]**
**[그래픽 전환 — 지도에 붉은 점 급증, 약 20개]**
**앵커 (목소리 낮지만 안정 유지하려 노력):** “현재 화면에 보이는 것처럼 사건 확인 지역이 빠르게 늘고 있습니다. 경찰본청과 소방본부는 전국 단위로 비상 대응 중입니다.” (앵커의 손이 책상 아래에서 살짝 움직인다. 카메라는 상체만 잡는다.)
**21:28:47 ~ 21:30:30 [ON AIR]**
**[자막 — 가상 뉴스 연출]** `〈특보 체제 전환〉 기존 뉴스 큐시트 및 정규 편성 전면 중단`
**앵커 (목소리 더 낮아짐, 호흡 짧음):** “현재까지 확인된 발생 지점은 40곳 이상으로 늘어났습니다… 시청자 여러분께서는 외출을 삼가고 실내에 머무르며 안전을 확보하시기 바랍니다. 저희는 예정된 9시 뉴스 리포트와 이후 모든 정규 편성을 중단하고 밤샘 긴급 뉴스 특보 체제로 전환합니다.”
**21:32 [CONTROL ROOM — 방송사 보도국 부조정실]****벽면을 가득 채운 멀티뷰 모니터 16개가 동시에 점멸한다. 전국 지역 총국 중계 회선, SNS 실시간 크롤링 창, 통신 3사 트래픽 지표, 타사 뉴스 피드가 숨 가쁘게 엇갈린다. 부조정실 안에는 인이어 마이크를 낀 스태프들의 마른 고함과 키보드 타건음만이 자욱하다.
부조정실 PD:** “CG팀! 전국 지도 그래픽 왜 아직 안 넘어와! 점 더 찍어, 지금 충청권이랑 호남권 지점도 추가됐잖아!”
**CG 감독:** “선배, 지금 몇 개로 찍어요? 경찰본청 출입기자는 58곳이라는데 소방본부 라인은 63곳이래요! 숫자가 계속 바뀌어요!”
**메인 작가:** “데스크에서 확인 안 된 지점은 점 찍지 말래요! 오보 나면 감당 안 된다고—”
**부조정실 PD:** “지금 오보 따지게 생겼어?! 화면 비잖아! 숫자 단정하지 말고 자막 바에 ‘최소 60곳 이상’으로 묶어! ‘이상’ 붙여, 빨리! 앵커 인이어 열어!”
**부조정실 PD (앵커 콜):** “선배님, 프롬프터 무시하고 제 콜만 들으세요. 확정 수치 절대 부르지 마시고 ‘최소 60여 곳’으로 넓혀 잡으세요. 단정 어미 쓰지 마십시오. 큐!”
수치는 단정 대신 범위가 된다. 통제실은 공포를 증폭시키지 않으면서도 상황의 심각성을 전달해야 한다. 정보가 부족할수록 표현은 신중해지고, 신중할수록 브라운관 너머의 시청자는 더 불안해진다.
**21:38 [CONTROL ROOM]****현장 중계차(ENG) 회선이 연결되자마자 날카로운 유리 파열음과 시민들의 비명이 부조정실 스피커를 찢을 듯이 울린다. 오디오 콘솔의 피크(Peak) 미터가 일제히 붉은색 끝까지 치솟는다.
오디오 감독:** “서울 ○○구 중계차 현장음 피크 칩니다! 비명 소리 너무 크게 물려요!”
**부조정실 PD:** “엠비언스(현장음) 페이더 확 깎아! 마이너스 15데시벨 밑으로 눌러! 비명 소리 그대로 나가면 거실에 있는 사람들 패닉 와!”
**메인 작가 (떨리는 목소리로):** “선배… 근데 저 현장 소리 다 빼면 밖이 얼마나 위험한지 사람들이 모르잖아요. 지금 다들 단순 화재인 줄 알고 밖으로 나오고 있다는데…”
**부조정실 PD (콘솔을 내리치며):** “비명 내보내서 현장에 인파 몰리고 대형 안전사고 나면 네가 책임질 거야?! 지금은 사실 전달보다 안정이 우선이야! 오디오 감독님, 현장 마이크 아예 죽이고 앵커 보이스만 살리세요!”
현장의 혼란은 페이더 하나로 편집된다. 국가의 공포 데시벨은 부조정실 유리창 안에서 인위적으로 조절된다.
**21:42 [CONTROL ROOM]****벽면 우측 상단, 경쟁사 모니터 화면 하단에 시뻘건 자막이 먼저 치고 올라온다. `〈긴급속보 : 대한민국 전역 동시다발 테러 발생 (가상 연출)〉` 부조정실이 순간 얼어붙는다.
수석 부장 (데스크):** “야, 저쪽 ‘테러’ 자막 박았다! 우리도 가야 하는 거 아냐? 시청률 다 뺏긴다!”
**부조정실 PD:** “안 됩니다, 부장님. 정보당국도 경찰본청도 아직 테러 규정 안 했어요. 지금 공영방송 자막에 ‘테러’ 두 글자 찍히는 순간, 단순 사고가 아니라 전쟁 상태가 됩니다. 도로고 병원이고 다 마비돼요.”
**수석 부장:** “그럼 뭐라고 내보낼 건데! 전국이 다 불타고 있는데!”
**부조정실 PD:** “‘동시다발적 복합 위기 가능성’. 우리는 끝까지 ‘가능성’ 유지합니다. 배후 확인될 때까지 절대 확정 안 합니다.”
언론은 정보를 전하지만, 동시에 사회가 감당할 수 있는 언어의 수위를 선택한다. ‘테러’라는 단어를 쓰는 순간, 사회는 되돌아올 수 없는 다른 단계로 이동한다.
**22:03 [CONTROL ROOM]****종이컵의 커피가 식어 기름막이 떠 있다. 구석에서 속보 원고를 쳐내던 막내 작가가 휴대폰을 쥔 채 입술을 깨물며 울음을 삼키고 있다.
막내 작가:** “선배… 저기 방금 추가된 ■■구 지점이요… 우리 엄마 사는 아파트 바로 앞 시장이에요. 그쪽 기지국도 일반 통화 제한 묶였나 봐요, 아까부터 전화가 아예 안 돼요.”
**부조정실 PD (모니터에서 눈을 떼지 못한 채, 낮고 갈라진 목소리로):** “…나도 본가 쪽 기지국 막혀서 통화 안 돼. 울지 마. 손 떨면 자막 오타 난다. 지금은 방송 먼저 해. 우리가 화면 끄는 순간 밖은 지옥 된다.”
개인의 공포는 국가적 재난 앞에서 무자비하게 보류된다. 카메라 앞에 앉은 앵커의 흔들림 없는 중저음은 시청자의 불안을 빨아들이는 거대한 방파제였다. 화면이 흔들리는 순간, 거리의 혼란은 걷잡을 수 없이 폭발할 것을 그 방의 모두가 알고 있었기 때문이다.
## 4. 140바이트의 문장과 끊어진 신호음 (재난문자와 T+34분 통신 통제)
**21:02 ~ 21:08 [재난문자 발송 콘솔 앞]****상황실 메인 모니터에 사건 목록이 폭포수처럼 쏟아진다. `[전국 동시다발 복합 위기 양상]`. 재난문자(CBS) 발송 콘솔 앞에 앉은 주무관의 손끝이 덜덜 떨린다. 키보드 위에 손을 올리자 상급자들의 고함이 머리 위로 쏟아진다.
1차 초안 입력:** `[긴급] 현재 전국 다수 지역에서 흉기 난동 및 방화 사건 동시 발생. 즉시 귀가 및 외출 자제 바랍니다.`
**상황담당관 (모니터를 가리키며):** “야, ‘전국’ 빼! ‘흉기·방화’도 빼! 밤 9시에 전국에 칼부림 났다고 문자 뿌리면 대형 상가고 터미널이고 사람들 한꺼번에 출구로 몰려서 2차 대형 사고 나! 단어 순화해!”
**발송 주무관:** “담당관님, 지금 SNS에 이미 다 퍼졌습니다! 모호하게 보내면 시민들이 대피를 안 해요!”
**2차 초안 입력:** `[긴급] 다수 지역 위기 사건 발생. 시민 여러분께서는 안전한 장소에 머무르십시오.`
**상황실장:** “어디 지역인데! 이렇게 두루뭉술하게 쓰면 장난 문자인 줄 알거나 오히려 확인하러 밖으로 나온단 말이야! 반대로 구 단위 지명을 다 적으면 그 동네로 가족 찾으러 차 몰고 들어가서 소방차 길 다 막혀! 딱 중간 수위로 다시 쳐!”
구체적이지 않으면 시민은 믿지 않는다. 그러나 너무 구체적이면 공포가 폭주한다.
**21:06****직통 전화기가 울린다. 통신 3사 망 관제센터다.
통신사 관제팀:** “주무관님, 지금 뉴스 속보랑 SNS 때문에 기지국 데이터·통화 트래픽이 가파르게 치솟고 있습니다! 장문 메시지나 데이터 패킷 섞이면 문자 발송 자체에 병목 걸려요! 무조건 한글 60자, 140바이트 이내 단문으로 쪼개서 쏘셔야 합니다! 시간 없습니다!”
140바이트. 오천만 국민에게 국가가 건넬 수 있는 공간은 고작 두 줄뿐이다.
**3차 초안 입력:** `[긴급] 현재 여러 지역에서 동시 사건 발생. 외출 자제 및 실내 대기 바랍니다.`
**상황실장 (결재 도장을 쥔 채 멈칫하며):** “…잠깐만. ‘동시 사건’이라고 쓰면, 국가가 조직적 기획 테러라고 공식 인정하는 꼴이 된다. 윗선에서 아직 배후 규정 못 했어. ‘동시’라고 확정합니까?”
**발송 주무관 (화면 속 불어나는 붉은 점들을 노려보며):** “실장님, 확정이 아니라 지금 눈앞에 벌어지는 현상입니다! 1분만 더 늦으면 거리에서 사람 더 죽습니다! ‘동시’ 빼고 ‘유사 사건 발생 양상’으로 바꾸겠습니다. 승인해 주십시오!”
**상황실장 (짧은 침묵 끝, 어금니를 악물며):** “…쏴라.”
**21:10 [T+28분 — 최종 발송 문안]**
**[긴급재난문자 — 가상 연출 문안] 현재 여러 지역에서 유사 사건 발생 양상. 시민 여러분은 실내에 머무르며 안전에 유의하시기 바랍니다. 추가 안내 예정.**
떨리는 검지가 엔터(Enter) 키를 깊숙이 누른다.**짧은 정적이 흐른다.
그리고 대한민국 전역에서 같은 주파수의 경고음이 동시에 울린다.
*삐—익. 삐—익.*
상황실 책상 위 수십 대의 휴대전화가 일제히 진동하며 붉은 경고창을 토해낸다. 그 시각, 멈춰 선 시내버스 안에서, 불 꺼진 아파트 거실에서, 피비린내 나는 응급실 복도에서 똑같은 문장이 동시에 떠올랐다. 상황실 구석에서 누군가 허탈하게 중얼거린다. *“이제 진짜 시작이네.”*
그 한 줄의 문장이 기지국을 통과하는 순간, 밤거리의 비명은 ‘소문’에서 ‘국가적 비상사태’로 공인되었다.
🎙️ 30년 후 담당자 인터뷰:** *“그날 저는 피 흘리는 사람을 본 게 아니라, 깜빡이는 커서와 글자 수만 봤습니다. ‘전국’을 쓸지 말지, ‘동시’를 넣을지 말지. 엔터 키 위에서 손가락이 한참 동안 얼어붙어 있었습니다. 제가 지금 국민들에게 안전을 보내는 건지, 아니면 거대한 공포의 방아쇠를 당기는 건지… 도무지 확신이 서지 않았거든요.”*
그리고 담당자의 두려움은 불과 몇 분 만에 현실이 되었다.
**21:14 ~ 21:16 [T+34분 — 중앙비상상황실 & 통신망 통합관제센터]****밤 9시 10분, 전국에 울려 퍼진 재난문자 경보음은 역설적이게도 국가 통신망의 숨통을 조이는 방아쇠가 되었다. 재난문자를 확인한 오천만 국민이 동시에 가족의 생사를 확인하려 수화기를 들면서, 발송 4분 만에 전국 기지국의 통화 시도 건수가 평시 대비 800%**를 돌파했다. 수천만 통의 전화가 기지국 교환기를 한꺼번에 덮치자, 정작 현장 경찰·소방 지휘부의 LTE 재난망과 응급의료 핫라인까지 연결 지연이 발생하기 시작했다.
**통신관제 파견관:** “실장님, 재난문자 나간 직후부터 전국 통화량이 폭발해서 수도권이랑 주요 대도시 기지국 호(Call) 처리 용량이 임계치 넘었습니다! 이대로 두면 현장 지휘 무전이랑 병원 이송 핫라인까지 다 같이 뻗습니다!”
**상황실장:** “비상 대역폭 확보 매뉴얼 단계 올려. 일반 민간 통화 비율 어디까지 묶을 수 있어?”
**통신관제 파견관:** “비상 통신 우선권 재배분 명령 발동하면, 사건 발생 권역 기지국의 일반 음성·데이터 세션을 강제로 끊고 긴급통신 채널에 대역폭 70%를 강제 할당할 수 있습니다. 다만… 지금 연결되어 있는 시민들 통화도 즉시 끊깁니다.”
**상황실장 (전광판의 붉은 점들을 올려다보며 잠시 침묵한다):** “…지휘망 죽으면 현장 대원들 눈감고 싸우는 꼴 된다. 지금 당장 일반 통화 세션 제한 걸어. 지휘·응급 채널 우선 확보해.”
**통신망 통합관제센터 엔지니어 (수화기 너머):** “행정명령 코드 확인했습니다. 21시 16분 정각부로 제1권역부터 민간 세션 강제 드롭 및 대역폭 재배분 실행합니다.”
관제센터 메인 서버에 명령어가 입력된다.**화면을 가득 채우고 있던 초록색 실시간 통화 연결 그래프가, 밤 9시 16분 정각을 기해 절벽처럼 수직으로 꺾여 내려간다.
그 순간 전국에서 수십만 개의 통화가 한꺼번에 끊겼다.
*“엄마, 여기 연기가 차서—”*
*“여보, 지금 어디야, 목소리가—”*
문장은 끝맺지 못한 채 차가운 기계음(`뚜— 뚜— 뚜—`)으로 바뀌었다. 국가의 신경망을 살리기 위해 개인의 연결선을 자른 시간이었다. 재난문자가 국민을 깨운 지 불과 6분 뒤인 밤 9시 16분, 수화기 너머로 내려앉은 그 침묵은 많은 가족들에게 영원히 이어지지 못한 마지막 통화로 남았다.
*(2부에서 계속)*
#### 📂 모큐멘터리 5부작 《확정 불가 ― 어느 밤과 그 이후 30년의 기록》 연재 목차
사건 최초 발생 시각인 매일 저녁 20시 42분**에 순차 공개됩니다.
- ▶ 현재글 1부. 프롤로그 : 준비와 대비의 간극, 그리고 20시 42분
- [2부. 생존의 계산 : 연기의 복도와 검은 태그, 그리고 30년 뒤의 눈물](https://mixedlog.com/archives/2176) (11/10 20:42 공개)
- [3부. 물리력의 경계 : 당기지 못한 방아쇠와 스무 살 병사의 실탄](https://mixedlog.com/archives/2177) (11/11 20:42 공개)
- [4부. 확정 불가와 의심 : 지하 회의실의 붉은 펜과 1도의 균열](https://mixedlog.com/archives/2178) (11/12 20:42 공개)
- [5부(완결). 번호에서 이름으로 : 안치소의 번호표와 삭제된 백서, 그리고 30년 후](https://mixedlog.com/archives/2179) (11/13 20:42 공개)
---
# 추격의 기하학 (1): 동남아는 정말 한국을 따라잡고 있는가? — 비율 격차와 절대 격차, 그리고 한·일 66년이 증명한 3단계 법칙
*Published on 2026-11-07 by canard | Category: 연구 & 비평*
**URL**: https://mixedlog.com/archives/2041
---
페낭과 박닌의 반도체 열기 뒤에 뒤섞인 두 개의 기준(비율 격차와 절대 격차), 한국과 일본의 66년 실측 데이터가 증명한 추격의 3단계 궤적, 그리고 1인당 역전에도 불구하고 총량 추월이 사실상 불가능에 가까운 체급의 법칙
## 페낭과 박닌의 열기, 그리고 질문 속에 뒤섞인 잣대들
최근 글로벌 공급망 재편을 다룬 경제 뉴스에서 가장 역동적으로 호명되는 지역은 동남아시아다. 오랫동안 저렴한 인건비에 기댄 봉제·신발 조립 기지로 기억되던 아세안(ASEAN) 주요국들이 반도체 패키징과 전기차, 인공지능(AI) 데이터센터의 새로운 생산 거점으로 부상하고 있기 때문이다.
현장의 투자 속도만 보면 열기는 분명 실체가 있다. 말레이시아 정부는 2024년 5월 ‘국가반도체전략(NSS)’을 발표하며 최소 250억 링깃의 정책 자금을 내걸었다. 1970년대부터 서구 전자 기업들이 자리 잡은 페낭(Penang)은 이미 세계 반도체 후공정(조립·패키징·테스트, OSAT) 시장의 약 13%를 담당하고 있으며, 인텔의 첨단 패키징 라인과 독일 인피니온(Infineon)의 쿨림(Kulim) 탄화규소(SiC) 전력반도체 증설이 이어지고 있다. 베트남 역시 2024년 9월 총리 결정문 제1018호를 통해 국가반도체전략을 수립하고 2030년까지 반도체 엔지니어 5만 명 양성을 선언했다. 하노이 인근 박닌(Bắc Ninh)성 산업단지에서는 삼성전자의 복합 생산기지와 더불어 미국 앰코 테크놀로지(Amkor)가 16억 달러를 투입한 대형 시스템인패키지(SiP) 공장이 가동 중이다.
이 분주한 풍경 위에서 익숙한 추격 담론이 고개를 든다. 고령화와 성숙기 진입으로 잠재성장률이 연 2% 안팎까지 내려앉은 한국과 달리 베트남은 연 6~8%, 인도네시아와 말레이시아는 연 5%대 성장을 거듭하고 있으니, 머지않아 동남아가 한국과의 경제 격차를 빠르게 허물고 턱밑까지 따라붙을 것이라는 진단이다.
하지만 “동남아가 한국을 따라잡고 있는가?”라는 물음은 언뜻 단순해 보여도 그 안에 서로 다른 질문 여러 개가 한데 엉켜 있다. 엉킨 실타래를 풀지 않고 한마디로 답하려 하면, 성급한 위기론이나 안일한 낙관론 둘 중 하나에 빠지게 된다. 정확한 진단을 내리려면 먼저 질문 속에 숨어 있는 **두 가지 기준**을 분리해 놓아야 한다.
- **‘격차’를 비율 배수로 재는가, 실제 달러 차이로 재는가:** 우리가 일상에서 쓰는 “격차를 좁힌다”는 말에는 두 경제의 **상대적 배율(선도국 ÷ 후발국)**이 줄어드는 현상과 **절대적 금액 간극(선도국 − 후발국)**이 줄어드는 현상이 뒤섞여 있다. 뒤에서 확인하듯, 체급 차이가 큰 두 나라 사이에서는 비율 배수가 해마다 줄어드는 동안 실제 달러 간극은 수십 년 내내 오히려 더 벌어지는 역설이 발생한다.
- **세 가지 GDP 렌즈와 환율 프리즘 중 무엇으로 비교하는가:** 똑같은 두 나라를 놓고도 **세 가지 핵심 GDP 렌즈**—① 시장 환율로 환산한 **국가 전체 명목 GDP**, ② 현지 물가 차이를 보정한 **구매력평가(PPP) GDP**, ③ 이를 인구수로 나눈 **1인당 GDP**—중 무엇으로 보느냐, 그리고 그사이에 끼어드는 **외환시장의 환율 프리즘**을 어떻게 보정하느냐에 따라 결론이 정반대로 갈린다. 인구 체급과 환율, 물가 구조가 렌즈마다 숫자를 전혀 다른 방향으로 굴절시키기 때문이다.
앞선 단편 [「GDP와 파이의 역설」](/archives/2035)에서 한 국가 내부의 성장률(%)과 연간 증분의 관계를 살펴보았다면, 오늘부터 8주간 매주 이어질 이 연재에서는 한국과 동아시아·동남아 경제의 실제 거리를 여덟 개의 주제에 걸쳐 차근차근 해부한다. 그 출발점인 이번 제1편에서는 국가 간 추격을 지배하는 **‘복리 추격의 3단계 법칙’**을 세우고, 이 법칙이 지난 66년(1960~2026년) 한국과 일본의 실제 역사에서 어떻게 작동했는지—그리고 왜 한국이 **1인당 소득에서는 일본을 넘어섰으면서도 국가 전체 총량에서는 일본을 넘어서는 것이 사실상 불가능에 가까운지**—를 실측 데이터로 증명한다.
## 비율 격차와 절대 격차의 엇갈림: 추격의 3단계 복리 법칙
먼저 복잡한 거시지표 대신 가장 직관적인 숫자 모형으로 비율 격차와 절대 격차가 왜 서로 반대 방향으로 움직이는지부터 확인해 보자. 현재 선도국의 경제 규모가 **100**이고 매년 **2.0%**씩 완만하게 성장한다고 가정하자. 후발국의 경제 규모는 선도국의 4분의 1인 **25**이지만, 선도국보다 세 배 빠른 매년 **6.0%**의 속도로 맹추격한다. 딱 1년이 지났을 때 두 나라의 경제 격차는 줄어들었을까, 늘어났을까?
정답은 **“비율 배수로 재면 첫해부터 줄어들었고, 실제 금액 차이로 재면 오히려 더 벌어졌다”**이다.
- **비율 격차 (선도국 ÷ 후발국):** 출발 시점에 선도국은 후발국의 **4.00배**(100 ÷ 25)다. 1년 뒤 선도국이 102.0이 되고 후발국이 26.5가 되면 두 경제의 배율은 **3.85배**(102.0 ÷ 26.5)로 낮아진다. 후발국 경제가 선도국의 25.0% 수준에서 26.0% 수준으로 올라선 것이다. 후발국의 성장률이 선도국보다 0.1%포인트라도 높은 한, 초기 체급 차이가 4배든 10배든 비율 배수는 첫해부터 예외 없이 축소된다.
- **절대 격차 (선도국 − 후발국):** 이번에는 두 경제 사이의 실제 금액 거리를 뺄셈으로 재어 보자. 출발 시점의 거리는 100 − 25 = **75.0**이었다. 1년 동안 선도국은 자기 체급 100의 2.0%인 **+2.0**을 새로 보탰고, 후발국은 자기 체급 25의 6.0%인 **+1.5**를 새로 보탰다. 그 결과 1년 뒤 두 경제의 실제 금액 차이는 102.0 − 26.5 = **75.5**가 되어 출발 때보다 **0.5만큼 더 멀어진다.**
도로 위 자동차 추격전을 떠올리면 왜 많은 사람이 직관의 함정에 빠지는지 쉽게 이해된다. 고속도로에서 뒤차가 시속 60km, 앞차가 시속 20km로 달리면 두 차 사이의 출발 거리가 아무리 멀어도 액셀을 밟는 첫 1초부터 실제 거리가 좁혀진다. 자동차 속도는 매시간 일정한 물리적 거리(km)를 더하는 산술 속도이기 때문이다. 반면 경제성장률(%)은 고정된 금액을 더하는 속도가 아니라, **해마다 커지는 자기 몸집(기저 체급)에 곱해지는 복리 비율**이다. 기준 연도의 달러 가치로 평가했을 때 한 해 동안 새로 불어난 실질 부가가치, 즉 **‘연간 실질 증분(기저 체급 × 실질 성장률)’**을 비교해 보면 체급이 4배 큰 선도국의 2%가 후발국의 6%보다 더 무겁다.
> **[인포그래픽 시각화 다이어그램]** 초기 규모가 4배(100 대 25) 차이 날 때 후발국이 3배 빠른 속도(6.0% 대 2.0%)로 성장하면, 비율 배수는 첫해부터 4.00배→3.85배→2.94배(8년 차)로 꾸준히 좁혀진다. 하지만 실제 금액 차이(절대 격차)는 8년 차까지 75.0에서 77.3으로 도리어 벌어진 뒤에야 줄어들기 시작한다.
위 **그림 1**은 이 단순한 원리가 42년에 걸쳐 만들어내는 **‘추격의 3단계 궤적’**을 보여준다.
- **1단계 — 비율 축소 · 절대 격차 확대 구간 (0~8년 차):** 초기 체급 배율(4.0배)이 성장률 배율(6.0% ÷ 2.0% = 3.0배)보다 큰 동안에는 후발국이 아무리 빨리 달려도 한 해에 보태는 절대 증분이 선도국보다 작다. 이 기간에 비율 배수는 4.00배에서 2.94배로 부지런히 내려오지만, 실제 금액 차이는 75.0에서 **8년 차 정점인 77.3**(선도국 117.2 − 후발국 39.8)까지 도리어 불어난다. 추격하는 나라 국민 입장에서는 “매년 6%씩 땀 흘려 성장하는데 선진국과의 실제 소득 차이는 왜 해마다 더 벌어지는가”라는 조바심이 가장 극심해지는 구간이다.
- **2단계 — 연간 증분 역전 · 동시 축소 구간 (9~36년 차):** 비율 추격이 누적되어 마침내 두 나라의 체급 배율이 성장률 배율인 ‘3.0배’ 아래로 내려오는 9년 차가 변곡점이다. 이때부터 비로소 후발국이 한 해에 새로 보태는 증분(39.8 × 6% = +2.39)이 선도국의 증분(117.2 × 2% = +2.34)을 앞지른다. 산봉우리 정점(77.3)을 찍은 절대 격차가 처음으로 내리막을 타며, 비율과 절대 격차가 나란히 줄어들기 시작한다. 다만 그동안 쌓인 산이 워낙 높아 실제 추월까지는 여기서도 28년을 더 달려야 한다.
- **3단계 — 교차 및 역전 구간 (36년 차 이후):** 출발 후 36년 차, 양국 규모 약 204 지점에서 마침내 두 곡선이 교차하며 후발국이 선도국을 넘어선다.
혹시 이 3단계 곡선이 깔끔한 종이 위에서만 성립하는 교과서 속 산수 모형은 아닐까? 그렇지 않다. 지금으로부터 꼭 한 세대 전, 극빈국에서 출발해 선진국 문턱을 두드리던 **대한민국이 일본을 추격하며 몸소 통과했던 66년의 실측 궤적**이 바로 이 곡선과 소름 끼치도록 똑같은 모양을 그리고 있기 때문이다.
## 한·일 66년 추격사(1960~2026)로 검증한 3단계 법칙: ‘한강의 기적’ 내내 절대 격차는 벌어지고 있었다
세계은행 세계개발지표(WDI)의 1960~2025년 확정 시계열과 2026년 10월 국제통화기금(IMF) 세계경제전망(WEO) 수치를 결합해, 지난 66년 동안 한국과 일본의 **1인당 소득**이 어떤 궤적을 그리며 움직였는지 실제 숫자로 복기해 보자. 환율 변동의 착시를 걸러내기 위해 당해 시장 환율로 환산한 **‘1인당 명목 달러’**와 환율·물가 변동을 고정한 **‘2015년 불변 실질 달러’**를 나란히 대조하면, 추격의 3단계가 역사 속에서 어떻게 작동했는지 한눈에 드러난다.
> **[인포그래픽 시각화 다이어그램]** 그림 1의 이론 곡선은 한·일 66년 추격사에서 그대로 재현되었다. 한국이 연 8~10% 고성장을 달리던 1965~1990년 내내 일본과의 비율 배수는 7.5배→3.0배로 줄었지만, 실질 소득의 절대 격차는 1990년(+$19,232), 초엔고가 겹친 명목 달러 절대 격차는 1995년(+$31,946)까지 치솟은 뒤에야 2단계(축소)와 3단계(역전)로 넘어갔다.
| 연도 (추격 단계) | 일본 1인당 명목$ (2015 실질$) | 한국 1인당 명목$ (2015 실질$) | 1인당 명목 배율 (실질 배율) | 1인당 절대 격차: 명목$ (2015 실질$) | 국가 전체 명목 GDP (일본 vs 한국) |
| --- | --- | --- | --- | --- | --- |
| 1966년 (1단계 초기) | $1,168 ($10,578) | $134 ($1,405) | 8.69배 (7.53배) | +$1,033 (+$9,173) | 1,154억$ vs 40억$ (29.2배) |
| 1970년 (1단계) | $2,145 ($14,319) | $282 ($2,001) | 7.61배 (7.16배) | +$1,863 (+$12,318) | 2,218억$ vs 91억$ (24.4배) |
| 1980년 (1단계) | $9,872 ($19,614) | $1,746 ($4,140) | 5.66배 (4.74배) | +$8,127 (+$15,474) | 1조 1,532억$ vs 665억$ (17.3배) |
| 1990년 (실질 격차 정점) | $26,345 ($28,905) | $6,813 ($9,673) | 3.87배 (2.99배) | +$19,532 (+$19,232 정점) | 3조 2,530억$ vs 2,921억$ (11.1배) |
| 1995년 (명목 격차 정점) | $44,947 ($30,505) | $13,002 ($13,924) | 3.46배 (2.19배) | +$31,946 정점 (+$16,580) | 5조 6,396억$ vs 5,863억$ (9.6배) |
| 2005년 (2단계 추격) | $38,159 ($33,386) | $20,167 ($22,124) | 1.89배 (1.51배) | +$17,992 (+$11,262) | 4조 8,756억$ vs 9,717억$ (5.0배) |
| 2015년 (2단계 추격) | $35,665 ($35,665) | $30,172 ($30,172) | 1.18배 (1.18배) | +$5,493 (+$5,493) | 4조 5,344억$ vs 1조 5,392억$ (2.95배) |
| 2023년 (3단계 진입) | $35,215 ($37,903) | $35,674 ($36,348) | 0.99배 (1.04배) | −$459 역전 (+$1,555) | 4조 3,849억$ vs 1조 8,448억$ (2.38배) |
| 2025년 (WDI 확정) | $35,951 ($38,619) | $36,227 ($37,470) | 0.99배 (1.03배) | −$276 역전 (+$1,150) | 4조 4,352억$ vs 1조 8,724억$ (2.37배) |
| 2026년 (IMF 10월 전망) | $35,400 (—) | $43,512 (—) | 0.81배 (—) | −$8,112 한국 우위 | 4조 3,900억$ vs 2조 2,458억$ (1.95배) |
> *자료: 자료: 세계은행 WDI(1966~2025년 확정치, NY.GDP.PCAP.CD · NY.GDP.PCAP.KD · NY.GDP.MKTP.CD) 및 IMF 세계경제전망(2026년 10월). 1인당 절대 격차는 ‘일본 − 한국’ 기준이므로 음수(−)는 한국이 일본을 추월한 상태를 뜻한다.*
**그림 2**의 아래쪽 패널(한·일 1인당 절대 소득 격차)에 솟아 있는 거대한 산봉우리를 자세히 들여다보자. 이 산봉우리 하나에 한국 현대 경제사 66년의 역설이 고스란히 압축되어 있다.
### 제1단계 (1960년대~1995년): 연 9% 질주 속에서도 30년간 멀어지기만 했던 일본의 등
한일 국교정상화 직후이자 경제개발 5개년 계획이 본격화되던 **1966년**, 한국의 1인당 명목 소득은 **134달러**였고 이미 전후 고도성장에 올라탄 일본은 **1,168달러**로 한국의 **8.69배**(1965년 기준 9.3배)에 달했다. 이후 30년 동안 한국은 경부고속도로를 깔고 포항제철의 고로를 지피며 중화학공업과 전자·자동차로 도약해 세계가 ‘한강의 기적’이라 부른 연평균 8~10%의 고성장을 달성했다. 그 덕분에 일본과의 1인당 명목 비율 배수는 1970년 7.61배, 1980년 5.66배, 1990년 3.87배, 1995년 3.46배로 쉼 없이 좁혀졌다.
그런데 같은 30년 동안 두 나라 국민 사이의 **실제 달러 거리(절대 격차)**는 어떻게 움직였을까? 놀랍게도 단 한 번도 좁혀지지 않고 30년 내내 폭발적으로 벌어졌다. 환율 변동을 완전히 제거한 **2015년 불변 실질 달러(주황색 점선)**로 재어도 한·일 1인당 실질 소득 차이는 1966년 9,173달러에서 1970년 1만 2,318달러, 1980년 1만 5,474달러를 거쳐 서울올림픽 직후인 **1990년 1만 9,232달러로 역사상 최고 정점**을 찍었다. 여기에 1985년 플라자 합의 이후의 초엔고 효과까지 더해진 **당해 명목 달러(적갈색 실선)** 기준으로는, 한국이 OECD 가입을 눈앞에 두고 1인당 1만 3,002달러를 돌파했던 **1995년**에 일본이 4만 4,947달러까지 치솟으며 두 나라 국민의 명목 소득 격차가 무려 **3만 1,946달러**로 역대 최대치를 기록했다.
1990년대 초중반 한국 사회를 지배했던 묘한 감각—공장은 밤낮없이 돌아가고 수출은 매년 신기록을 경신하는데 도쿄와 서울의 거리는 외려 아득하게 느껴지던 감각—은 기분 탓이 아니었다. 초기 체급 배율(8~9배)이 성장률 배율보다 훨씬 컸던 탓에, 한국이 연 9%를 달려도 거대 체급 일본이 연 3~4% 성장과 통화 강세로 보태는 연간 달러 증분이 더 컸던 전형적인 **‘추격의 1단계’** 한복판에 있었기 때문이다.
### 제2단계 (1995~2022년)와 제3단계 (2023~2026년): 산봉우리를 넘어 1인당 역전에 이르기까지
1990년대 중반 한국의 1인당 체급이 일본의 3분의 1(명목 3.46배, 실질 2.19배) 고지까지 올라서고, 동시에 자산 버블이 붕괴한 일본이 연 0~1%대 장기 정체에 빠지면서 마침내 기어가 **‘2단계’**로 전환되었다. 한국의 1인당 연간 증분이 일본을 추월하자 3만 1,946달러에 달했던 거대한 절대 격차의 산이 깎여 나가기 시작했다. 1997년 외환위기와 2008년 글로벌 금융위기라는 일시적 출렁임을 겪으면서도 격차는 2005년 1만 7,992달러, 2015년 5,493달러, 2022년 726달러로 가파르게 좁혀졌다.
그리고 마침내 **‘3단계(역전)’**가 문을 열었다. 현지 물가를 반영한 1인당 구매력평가(PPP) 소득에서는 이미 2017~2018년(2018년 한국 4만 5,511달러 vs 일본 4만 3,090달러)에 한국이 일본을 넘어섰고, 가장 냉정한 시장 환율 기준 **1인당 명목 달러 소득**에서도 출발 63년 만인 **2023년**(한국 3만 5,674달러 vs 일본 3만 5,215달러)에 첫 역전이 일어났다. 원화 약세가 심했던 2025년(세계은행 확정 한국 3만 6,227달러 vs 일본 3만 5,951달러)에도 한국은 근소한 우위를 지켰다. 이어 2026년 가을에는 AI 메모리 반도체 호황에 힘입어 원·달러 환율이 1,340원대로 안정된 반면 엔화는 157~158엔대 약세에 머물면서, **2026년 10월 IMF 전망** 기준 한국은 **4만 3,512달러**를 기록해 일본(3만 5,400달러)을 1인당 **8,112달러** 차이로 앞서 나가고 있다.
## 결정적 한계선: 한국은 왜 ‘국가 전체 총량’에서 일본을 넘기가 사실상 불가능에 가까운가
바로 이 지점에서 동남아와 한국의 관계를 정확히 읽기 위해 반드시 짚고 넘어가야 할 냉정한 물리 법칙이 하나 등장한다. 위 표의 가장 오른쪽 열(**국가 전체 명목 GDP**)을 다시 보자.
한국은 1인당 소득에서 추격의 1단계와 2단계를 모두 통과해 이미 3단계(역전)에 진입했다. 그렇다면 이 여세를 몰아 머지않아 **국가 전체 GDP 총량**에서도 한국이 일본을 추월하는 ‘총량의 3단계’가 찾아올까?
결론부터 명시하자면, 두 나라가 모두 성숙기 선진국 경제에 진입한 이상 **총량의 역전은 현실적으로 불가능에 가깝다.** 두 나라 사이에 가로놓인 **2.4배의 절대적 인구 체급 차이**를 총량에서 뒤집으려면 한국의 1인당 소득이 일본의 2.4배 이상으로 벌어져야 하는데, 기술 프런티어에 수렴한 인접 선진국 사이에서 그만한 생산성 격차가 발생하는 것은 사실상 불가능하기 때문이다.
- **인구 2.4배가 만드는 건널 수 없는 총량의 강:** 2025~2026년 현재 일본의 총인구는 약 **1억 2,337만 명**, 대한민국의 총인구는 약 **5,168만 명**으로 일본의 인구 체급이 한국의 **2.39배(약 2.4배)**다. 국가 전체 GDP는 `1인당 GDP × 총인구`의 곱이다. 따라서 두 나라 국민의 1인당 명목 소득이 거의 1 대 1 동률이었던 2025년(한국 3만 6,227달러 vs 일본 3만 5,951달러)에도, 국가 전체 명목 GDP 총량은 일본이 **4조 4,352억 달러**, 한국이 **1조 8,724억 달러**로 정확히 인구 배율만큼인 **2.37배**의 격차가 유지되었다.
- **총량 동률이 되려면 한국이 1인당 8만 5천~10만 달러가 되어야 한다:** 한국이 1인당 소득에서 일본을 23% 앞선 2026년(4만 3,512달러 vs 3만 5,400달러)에도 일본의 경제 총량(4조 3,900억 달러)은 여전히 한국(2조 2,458억 달러)의 **거의 두 배(1.95배, +2조 1,442억 달러 우위)**다. 인구 5,168만 명인 한국이 인구 1억 2,337만 명인 일본의 국가 총량과 어깨를 나란히 하려면, 한국인의 1인당 소득이 일본인의 2.4배인 **8만 5,000~10만 달러**—조세회피처나 산유 소국을 제외한 대형 제조업 국가 중 미국 정도만 도달한 초현실적 수준—까지 치솟는 동시에 일본은 제자리에 멈춰 있어야만 한다.
- **미래 인구 추계는 이 체급 격차를 오히려 고착시킨다:** 시간이 흐르면 인구 차이가 좁혀질 가능성도 없다. 일본 역시 고령화로 인구가 줄고 있지만 합계출산율이 1.15~1.20명 선인 반면, 한국은 0.7~0.8명대의 초저출산으로 인구 감소 속도가 일본보다 더 가파르다. 통계청과 유엔 인구 추계에 따르면 2050년(일본 약 1억 400만 명 vs 한국 약 4,711만 명)과 2070년 이후까지도 일본의 인구 체급은 한국의 **2.2~2.4배 이상**으로 유지된다.
한·일 경제사가 남긴 이 명쾌한 교훈—**“동일한 기술권의 성숙 선진국 사이에서 인구 체급이 2.4배 작은 나라는 생산성 혁신으로 1인당 소득을 역전할 수는 있어도 국가 총량까지 추월하기는 사실상 불가능에 가깝다”**—을 거울처럼 뒤집어 보면, 오늘날 한국과 동남아시아의 관계가 놀라울 만큼 투명하게 읽히기 시작한다.
한국(5,168만 명)과 일본(1억 2,337만 명)의 관계를 정반대로 뒤집어 놓은 나라가 바로 아세안 최대 대국 **인도네시아(약 2억 8,700만 명, 한국의 5.5배 인구)**다. 한국이 일본의 1인당 소득을 넘고도 인구 체급의 벽 앞에서 총량 추월이 가로막히듯, 거꾸로 인도네시아는 1인당 소득이 한국의 5분의 1~6분의 1 수준에만 도달해도 5.5배의 인구 체급을 지렛대 삼아 **국가 전체 총량에서는 한국을 넘어설 수 있다.** 반면 인구가 한국보다 적거나 엇비슷한 말레이시아(3,550만 명), 태국(7,160만 명), 그리고 아직 초기 자본 축적 체급이 4배 이상 차이 나는 베트남(1억 100만 명)은 국가 총량과 1인당 소득 모두에서 여전히 거대한 ‘1단계의 산봉우리’ 초입을 오르고 있다.
## 앞으로 7주간 펼쳐질 여정: 여덟 개의 렌즈로 재구성하는 추격의 지도
이처럼 “동남아가 한국을 따라잡고 있는가?”라는 질문은 단 하나의 숫자로 재단할 수 없다. 이번 8부작 연재는 오늘 확인한 복리 추격의 기하학을 나침반 삼아 매주 하나의 핵심 축을 깊숙이 파고든다.
- **국가 전체 명목 GDP와 체급의 물리학 (제2편):** 국경을 넘는 순간 작동하는 경화(달러) 결제력의 의미를 짚고, 한·일 총량 추월이 사실상 불가능에 가까운 체급의 법칙과 2035~2040년 사이에 놓인 한국·인도네시아 총량 교차 시뮬레이션을 검증한다.
- **환율의 프리즘, 그리고 구매력평가(PPP)와 중·말레이시아 수수께끼 (제3~4편):** 초엔고에서 슈퍼 엔저까지 지난 31년 환율 변동이 만든 한·일 달러 소득의 착시와 2026년 최신 아시아 외환시장의 대분화를 해부한 뒤(제3편), 하노이 쌀국수 물가가 만드는 동남아 PPP 5조 달러 내수 시장과 자본재 병목, 그리고 1인당 명목 소득은 1만 5천 달러로 똑같은데 왜 PPP 구매력은 말레이시아가 중국보다 1.5배 높게 갈라지는지 두 발전 모델을 한 호흡으로 엮어 파헤친다(제4편).
- **1인당 생산성 사다리, 동남아의 산업 장벽과 돌파구 (제5~6편):** 인구 증가율을 차감한 정확한 1인당 실질 증분과 로봇 밀도 1,012대의 힘, 그리고 한국 내부 ‘평균의 착시(시간당 노동생산성과 대·중소 이중구조)’를 직시하고(제5편), 중국 전기차에 흔들리는 태국 자동차 벨트와 세계은행 ‘3i’ 중진국 전환 장벽은 물론 조호르-싱가포르 경제특구(JS-SEZ)와 베트남의 인적자본 같은 동남아의 실질적 잠재력까지 공정하게 저울질한다(제6편).
- **인구 절벽의 경제학과 AI 시대 기술 주권 (제7~8편):** 한국에서 인구가 줄어 국가 전체 파이가 멈춰 서도 1인당 소득은 왜 계속 올라가는지, 그리고 한국·일본의 3분의 1 소득에서 급속히 늙어가는 중국의 ‘미부선로(未富先老)’ 충격을 분석한 뒤(제7편), 유럽 드라기 보고서의 경고를 거울삼아 인구 감소기 한국의 생존 방정식을 도출한다(제8편).
## 속도의 숫자와 거리의 숫자를 구별하는 것에서 분석은 시작된다
이번 제1편의 결론을 세 줄로 요약하면 다음과 같다.
- **비율 수렴과 절대 추격은 전혀 다른 시계로 움직인다:** 초기 체급 배율이 성장률 배율보다 큰 ‘추격의 1단계’에서는 후발국의 성장률이 두세 배 높아 비율 배수가 매년 줄어들더라도, 한 해 동안 손에 쥐는 실제 달러 간극(절대 격차)은 수십 년간 오히려 더 벌어진다.
- **한·일 66년 추격사가 이를 실증했다:** 한국이 연 8~10% 고성장을 구가하던 1966~1995년 내내 일본과의 1인당 비율 배수는 8.7배에서 3.5배로 줄었지만, 1인당 실질 달러 격차는 1990년(+1만 9,232달러), 명목 달러 격차는 1995년(+3만 1,946달러)까지 치솟은 뒤에야 비로소 줄어들기 시작해 2023~2026년 역전(3단계)에 도달했다.
- **1인당 역전이 곧 국가 총량의 역전을 뜻하지는 않는다:** 한국이 1인당 소득에서 일본을 8,000달러 이상 앞지른 2026년에도 일본의 국가 전체 GDP(4.39조 달러)는 한국(2.25조 달러)의 두 배에 육박하며, 성숙 선진국끼리 1인당 소득이 2.4배 이상 벌어지지 않는 한 한국의 대일 총량 추월은 사실상 불가능에 가깝다.
그렇다면 이 냉정한 체급의 물리학을 오늘날의 한국과 동남아 6개국에 그대로 대입하면 어떤 그림이 펼쳐질까? 국가 전체 명목 달러 총량이라는 첫 번째 렌즈 위에서 누가 아직 1단계의 비탈길에 서 있고, 누가 한국과의 총량 교차선을 향해 다가오고 있는지 다음 이야기에서 본격적으로 들여다본다.
**추격의 기하학 이론적 배경 및 관련 경제학 논고**
- [**GDP와 파이의 역설: 경제는 커지는데 왜 새로 늘어나는 몫은 줄어드는가?**](/archives/2035): 본편의 핵심 축인 '비율 격차와 절대 격차의 분기'를 지탱하는 거시경제 성장 모델과 미분 수리적 증명을 다룬 기초 논고입니다.
- [**경제는 커졌다는데 왜 작년보다 팍팍할까? — 체감 경기를 가르는 A구간과 B구간**](/archives/2106): 성장률 감속과 절대 파이 증가액의 관계를 실생활의 통장 잔고 비유로 쉽게 설명한 입문 에세이입니다.
**8주 연재 목차 · [추격의 기하학: 동남아는 정말 한국을 따라잡고 있는가?]**
- **1편 · 총론: 비율 격차와 절대 격차, 그리고 한·일 66년이 증명한 추격의 3단계 법칙 (현재 글)**
- 2편 · 국가 총량: 한·일 총량 추월이 사실상 불가능에 가까운 이유와 인도네시아 교차의 조건
- 3편 · 환율의 프리즘: 초엔고에서 슈퍼 엔저까지, 2026년 외환시장이 뒤흔드는 국부의 착시와 실체
- 4편 · 구매력평가(PPP)와 중·말레이 수수께끼: 쌀국수 물가, 자본재 병목, 같은 1만 5천 달러의 대분기
- 5편 · 1인당 소득과 생산성: 로봇 1,012대의 힘과 한국 내부 ‘평균의 착시’
- 6편 · 동남아 산업의 벽과 돌파구: 태국 자동차 벨트, 세계은행 3i 전략과 새로운 실험들
- 7편 · 인구 절벽의 경제학: 파이가 줄어도 1인당 소득은 느는 한국, 급속히 늙는 중국
- 8편(완) · 기술 주권과 AI 시대의 거울: 드라기 보고서의 경고와 한국의 생존 방정식
## 참고문헌
- Barro, R. J., & Sala-i-Martin, X. (1992). Convergence. *Journal of Political Economy*, 100(2), 223–251. [https://doi.org/10.1086/261816](https://doi.org/10.1086/261816)
- International Monetary Fund. (2026). *World Economic Outlook Database: October 2026 Edition*. Washington, DC: IMF. [https://www.imf.org/en/Publications/WEO](https://www.imf.org/en/Publications/WEO)
- Ministry of Investment, Trade and Industry (MITI) Malaysia. (2024). *National Semiconductor Strategy (NSS)*. Putrajaya: Government of Malaysia.
- Prime Minister of Vietnam. (2024). *Decision No. 1018/QD-TTg: Strategy for Development of Vietnam’s Semiconductor Industry to 2030 and Vision to 2050*. Hanoi: Government of Vietnam.
- World Bank. (2026). *World Development Indicators (WDI): Korea & Japan Long-Term National Accounts Series (1960–2025)*. Washington, DC: World Bank. [https://data.worldbank.org](https://data.worldbank.org)
---
# 도시계획의 동심원은 왜 타원이 될까?
*Published on 2026-11-05 by canard | Category: 연구 & 비평*
**URL**: https://mixedlog.com/archives/2051
---
시작점과 도착점에 시간축을 세웠더니 나온 ‘기울어진 팽이’
## 2018년의 타원
2018년에 시작점, 도착점, 이동거리로 경로를 계산하는 글([「시작점, 도착점, 이동거리를 이용한 경로계산」](https://mixedlog.com/archives/748))을 쓴 적이 있다. 문제는 단순했다. 지도 위에 출발점 A와 도착점 B가 있고, 오늘 걸을 수 있는 거리가 정해져 있다. 그러면 A에서 출발해 B에 도착하는 동안 중간에 어디까지 들를 수 있을까.
어떤 곳에 들르려면 “A에서 그곳까지 가는 거리”와 “그곳에서 B까지 가는 거리”를 더한 값이 내가 걸을 수 있는 거리보다 짧거나 같아야 한다. 이 조건을 만족하는 곳들의 경계를 그리면 타원이 나온다. A와 B가 타원의 두 초점이 된다.
압정 두 개를 꽂고 실을 느슨하게 걸어 연필로 팽팽하게 당기며 그리면 타원이 되는 것과 같은 원리다. 압정이 출발점과 도착점이고, 실의 길이가 이동 가능한 거리다. 걸을 수 있는 거리는 (걷는 속도) × (주어진 시간)이다. 그래서 실의 길이는 출발 시각과 도착 시각의 차이(주어진 시간)와 걷는 속도로 정해진다. 당시에는 결과가 깔끔하게 떨어지는 게 재미있어서 정리만 해 두고 넘어갔다.
## 지도에 시간을 세우면
최근에 이 문제를 다시 꺼냈다. 이번에는 질문을 하나 더했다. 평평한 지도 위에 위쪽 방향으로 시간축을 세우면 어떤 모양이 나올까.
아래에서 위로 올라갈수록 시간이 흐르는 3차원 공간을 생각하면 된다. 이 공간에 “언제, 어디에 있을 수 있는가”를 그려 보면 이렇게 된다.
- **출발하는 순간:** 아직 한 발짝도 움직이지 않았으니 갈 수 있는 곳은 출발점 하나다. 맨 아래의 뾰족한 점이다.
- **시간이 조금 흐르면:** 걸어갈 수 있는 반경이 점점 넓어진다. 위로 갈수록 벌어지는 원뿔이 된다.
- **도착 시각이 다가오면:** 정해진 시각에는 도착점에 있어야 한다. 그러려면 너무 멀리 가 있으면 안 된다. 마감이 가까워질수록 있을 수 있는 범위가 다시 좁아진다.
- **도착하는 순간:** 다시 도착점 하나로 모인다. 맨 위의 뾰족한 점이다.
이 두 원뿔을 맞붙이면 위아래가 뾰족하고 가운데가 불룩한 다이아몬드 팽이 모양이 된다. 두 원뿔은 각각 시간축을 따라 똑바로 서 있지만, 꼭짓점이 서로 다른 곳에 있어서 둘을 맞붙인 팽이는 도착점 쪽으로 비스듬히 기운 모양이 된다.
이 팽이에 바로 위에서 수직으로 빛을 비추면 바닥에 그림자가 생긴다. 그 그림자가 2018년에 구했던 바로 그 타원이다. 평면에서 계산한 타원은 이 입체를 위에서 내려다본 모습이었다.
그림 1: 꼭짓점이 어긋난 두 원뿔이 만든 시공간 프리즘과 바닥의 타원 그림자
## 이 팽이에는 이미 이름이 있다: 시간지리학
찾아보니 이 모양은 이미 한 학문 분야의 핵심 도구였다. 스웨덴의 지리학자 토르스텐 헤거스트란트(Torsten Hägerstrand)가 1970년 논문으로 널리 알린 **시간지리학(time geography)**이다.
시간지리학은 사람의 움직임을 지도 위의 선이 아니라 “지도 + 시간” 공간 안의 선으로 본다. 개념은 세 가지만 알면 된다.
- **시공간 경로:** 한 사람이 하루 동안 움직인 자취를 시간축 위에 그린 선이다. 한 자리에 가만히 있으면 선이 똑바로 위로 올라가고, 이동하면 옆으로 기운다. 빨리 움직일수록 더 많이 눕는다.
- **시공간 프리즘:** 출발점과 도착점, 시각, 이동 속도가 정해졌을 때 그 사람이 있을 수 있는 영역 전체다. 앞에서 그린 기울어진 팽이가 바로 이것이다.
- **잠재 경로 영역(통행가능면):** 프리즘의 그림자, 즉 주어진 시간 안에 발을 디딜 수 있는 지도 위의 범위다. 2018년의 타원이 여기에 해당한다.
헤거스트란트는 사람의 하루를 묶어 두는 제약도 세 가지로 나눴다.
- **능력 제약:** 걷는 속도, 차가 있는지, 잠을 자야 한다는 사실처럼 몸과 수단의 한계다. 팽이가 얼마나 넓게 벌어질 수 있는지를 정한다.
- **결합 제약:** 정해진 시각에 정해진 곳에 있어야 하는 약속이다. 9시 출근, 회의, 아이 하원 같은 것이다. 팽이의 꼭짓점을 못 박는다.
- **권한 제약:** 영업시간이나 출입 통제처럼 제도가 정한 규칙이다. 팽이 안에 있어도 실제로는 쓸 수 없는 부분을 잘라낸다.
2018년에 혼자 손으로 구했던 타원은 이 분야에서 이미 이름을 가지고 쓰이던 도구였던 셈이다.
## 팽이 모양을 정하는 것: 여유 시간과 거리
팽이를 몇 번 그려 보면 모양을 정하는 요소가 두 가지라는 걸 알 수 있다.
**팽이의 폭(뚱뚱함)**은 여유 시간이 정한다. 이동에 필요한 시간보다 주어진 시간이 넉넉할수록 팽이가 뚱뚱해진다. 중간에 들를 수 있는 곳이 많아진다는 뜻이다.
**팽이의 기울기**(두 꼭짓점을 잇는 선이 시간축에서 기운 정도)는 필요한 평균 속도가 정한다. 필요한 평균 속도가 최고 속도에 가까울수록 팽이가 눕는다. 가장 많이 누워도 원뿔 옆면의 기울기, 즉 최고 속도까지만 눕는다.
극단적인 경우를 보면 감이 잡힌다.
- **출발점과 도착점이 같으면:** 팽이가 똑바로 선다. 그림자는 출발점을 중심으로 한 원이다.
- **시간이 딱 맞으면:** 가는 데 필요한 시간과 주어진 시간이 정확히 같으면 여유가 하나도 없다. 팽이가 납작하게 눌려서 출발점과 도착점을 잇는 직선 하나가 된다. 곧장 가는 것 말고는 선택지가 없다.
- **시간이 모자라면:** 팽이 자체가 생기지 않는다. 제시간에 도착할 방법이 없다.
참고로 출발점과 도착점이 다를 때 팽이의 수평 단면, 즉 “어느 한 시각에 있을 수 있는 범위”는 출발 후 기울어진 허리의 아랫단에 닿기 전까지는 원이고, 허리를 가로지르는 중간 시간대에는 두 원이 겹친 렌즈 모양이 되었다가, 허리 윗단을 지나 도착할 때까지 다시 원이 된다. 두 원뿔이 만나는 허리 테두리는 도착점 쪽이 더 높게 기울어진 평면 위의 타원이다. 이 테두리를 바로 아래 바닥에 수직으로 비춘 것이 바닥의 타원 그림자다.
그림 2: 이동 여유와 거리에 따른 팽이 모양의 변화 (출발점 = 도착점인 원 → 기운 팽이 → 거의 선이 된 팽이)
## 두 꼭짓점의 정체: 집과 회사
여기까지 그려 놓고 보니 두 꼭짓점에 붙일 이름이 자연스럽게 떠올랐다. 예를 들어 출근길 한 구간을 떼어 놓으면 다음과 같다.
- **아래 꼭짓점:** 아침 8시의 집
- **위 꼭짓점:** 아침 9시의 회사
퇴근길이라면 아래 꼭짓점이 저녁 6시의 회사, 위 꼭짓점이 저녁 7시 반의 집이 된다. 수학 장난감으로 만든 기울어진 팽이는, 집과 회사 사이를 정해진 시각에 맞춰 오가는 사람이 그 이동 구간 동안 발을 디딜 수 있는 시공간 전체였다. 팽이 밖에 있는 장소는 지도상으로 아무리 가까워 보여도 그 일정 안에서는 들를 수 없는 곳이다.
## 서울역사박물관: 1966년의 동심원
이런 생각을 하던 즈음 서울역사박물관의 서울도시기본계획 수립 60주년 특별전 「서울 도시계획 대관람」을 봤다.
1966년 자료 중에 「근린주구공공시설기준」과 「공원계획모식도」가 있다. 앞의 자료는 집을 중심에 두고 가구 규모(20호~4,000호)가 커질수록 유치원, 국민학교, 소매시장, 도서관을 동심원 단계로 넓혀 가는 기준표이고, 뒤의 자료는 서비스 반경(250m~2,000m)에 따라 유아공원, 아동공원, 근린공원, 대공원을 동심원으로 배치한 모식도다.
시간지리학으로 보면 이 모델은 출발점과 도착점이 모두 집인 사람을 전제한다. 집에서 나와 동네에서 하루를 보내고 집으로 돌아오는 사람이다. 앞에서 본 것처럼 출발점과 도착점이 같으면 팽이는 똑바로 서고, 그림자는 집을 중심으로 한 원이 된다.
즉 1966년의 동심원은 두 초점이 한 점에 겹친 타원이다. 유아공원은 여유 시간이 적은 작은 원이고, 대공원은 여유 시간이 많은 큰 원이다. 동심원 하나하나는 여유 시간이 다른, 똑바로 선 팽이들의 그림자인 셈이다. 동네 안에서 하루를 보내는 사람에게는 이 배치가 정확히 맞는다.
그림 3: 1966년 근린주구 모델(좌, 초점 1개)과 2026년 출퇴근 타원(우, 초점 2개). 본문의 설명을 도식화한 개념도이며 실제 거리·시간 척도와 무관하다.
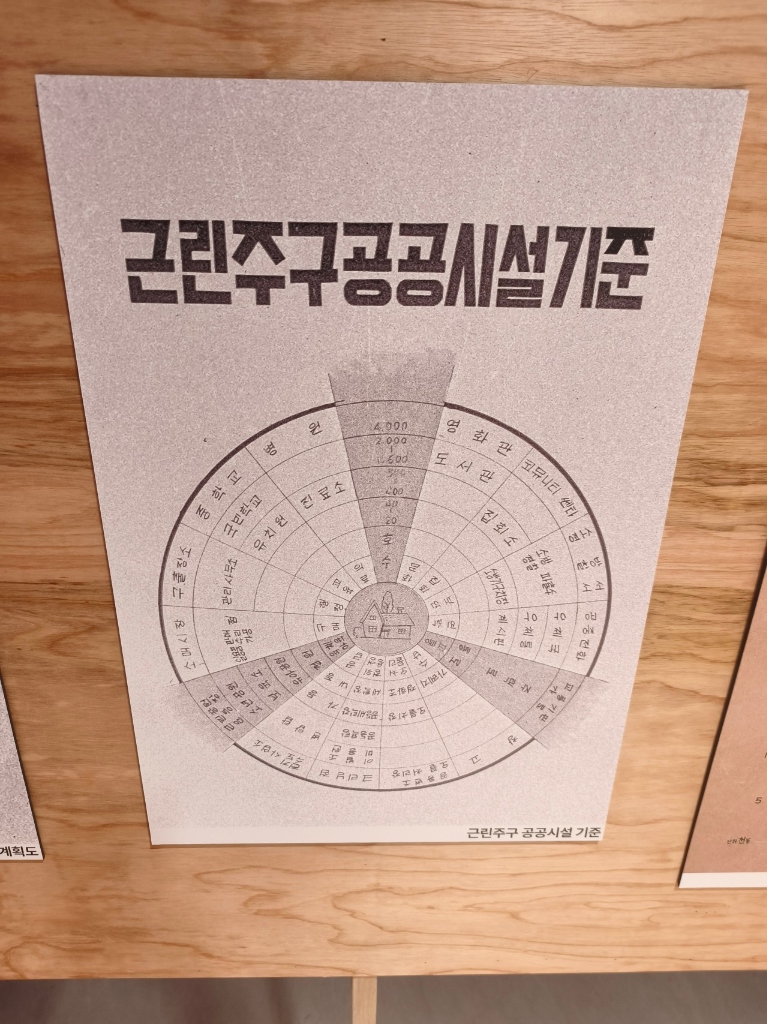전시 자료: 1966년 「근린주구공공시설기준」 (가구 규모 20~4,000호에 따른 집 중심의 동심원 위계)
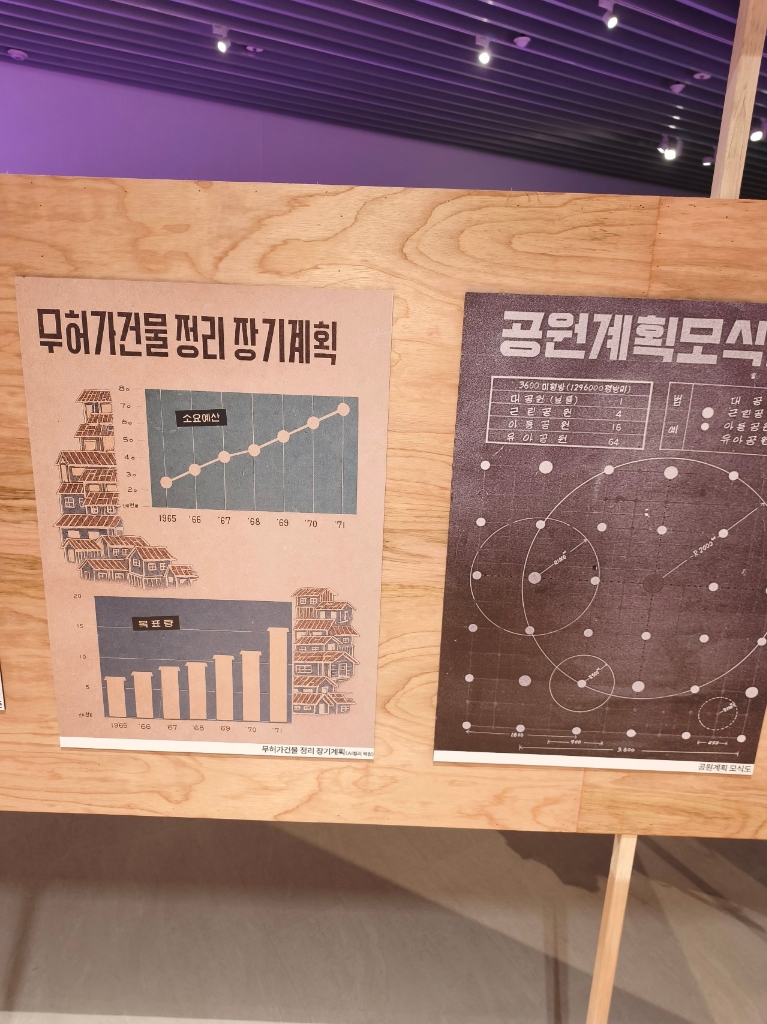전시 자료: 1966년 「공원계획모식도」 (반경 250m~2,000m의 유아·아동·근린·대공원 체계)
## 2026년 시민의 하루
같은 전시의 마지막에는 「도시 한 조각에 담긴 시민의 하루: 낮의 도시 / 밤의 도시」라는 드로잉이 있다. 패널에 기록된 시민의 하루 동선은 이렇다.
| 시각 | 위치 및 활동 |
| --- | --- |
| 07:30 | 집 근처 산책 (아이와 함께 걷는 아침) |
| 08:00 | 지하철역으로 가는 길, 출근 |
| 12:30 | 도심 공개공지에서 점심 후 휴식 |
| 18:10 | 퇴근 후 하천을 따라 산책 |
| 18:30 | 상업가로 |
| 20:00 | 동네 골목, 귀가 |
이 시민은 동심원 안에 머물지 않는다. 아침과 저녁의 두 점 사이를 대각선으로 오간다. 초점이 하나에서 둘로 갈라지는 순간, 1966년의 원은 옆으로 잡아당겨져 타원이 되고, 똑바로 서 있던 팽이는 회사 쪽으로 기운다.
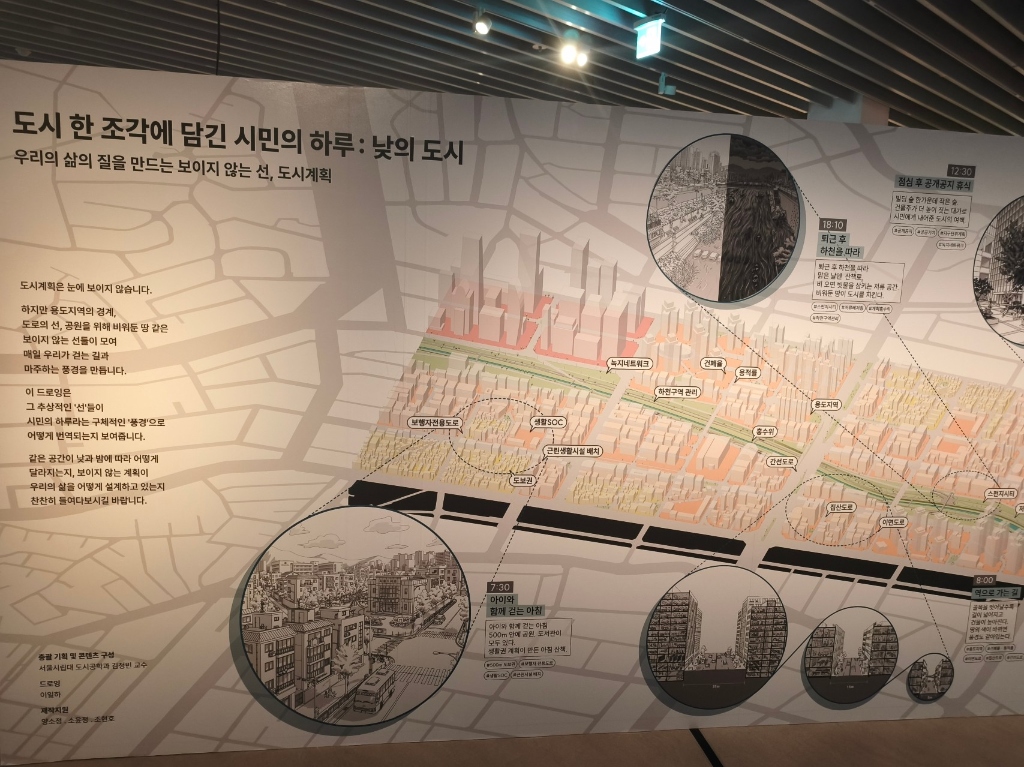전시 드로잉: 「도시 한 조각에 담긴 시민의 하루: 낮의 도시」 (07:30~18:10 시간대별 동선)
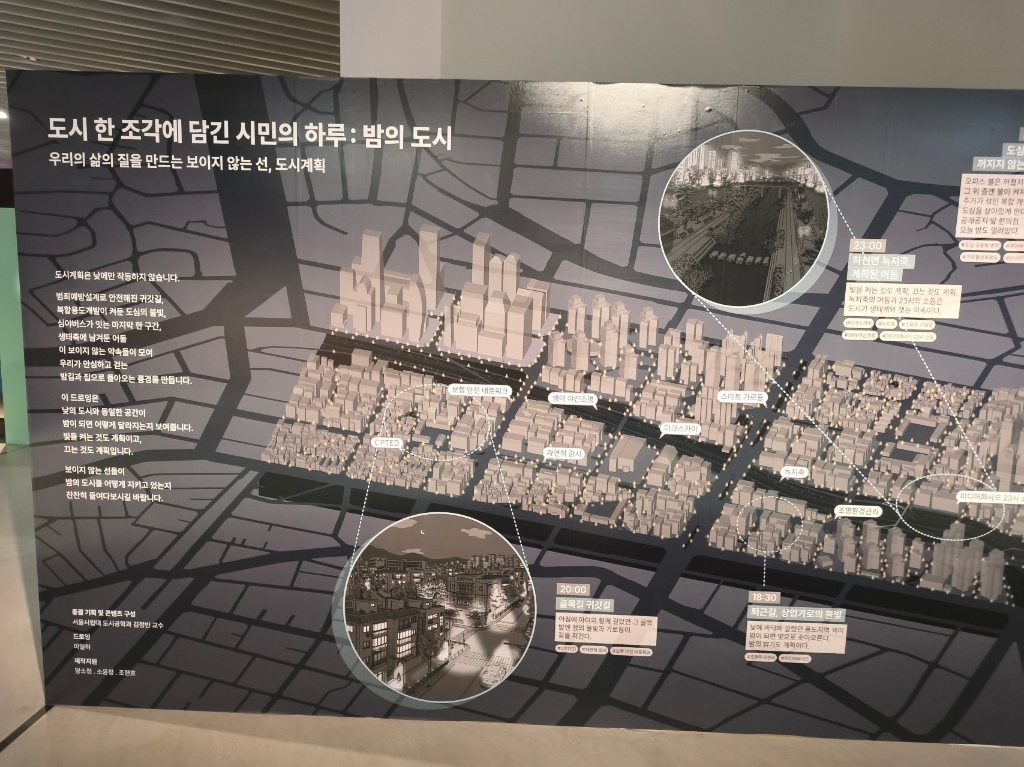전시 드로잉: 「도시 한 조각에 담긴 시민의 하루: 밤의 도시」 (18:30~20:00 귀갓길과 23:00 밤의 녹지축)
## 실제 하루는 팽이 여러 개를 이은 사슬이다
하루 전체를 놓고 보면 팽이 하나가 아니다. 아침 9시부터 저녁 6시까지는 회사에 머물러야 하니 그 시간대의 경로는 회사 위에 똑바로 선 수직 기둥에 가깝다. 헤거스트란트가 말한 결합 제약이다. 이 기둥의 앞뒤와 점심시간에 크고 작은 이동들이 붙으면서, 실제 하루는 팽이 여러 개와 기둥을 이은 사슬이 된다.
- **07:30 산책:** 집에서 나와 집으로 돌아오는 작은 팽이다. 똑바로 서 있다. 1966년의 동심원 모델이 가장 잘 들어맞는 구간이다. (20:00 귀가 후 동네 골목에서 보내는 시간도 마찬가지다.)
- **08:00 출근:** 집에서 회사로 가는 팽이다. 여유가 거의 없어 지하철 노선을 따라 거의 선으로 눌린다.
- **12:30 점심:** 회사에서 나와 회사로 돌아오는 작은 팽이다. 똑바로 서 있지만 중심은 집이 아니라 회사다. 도심 공개공지는 이 팽이 안에 있다.
- **18:10 이후 퇴근길:** 회사에서 집으로 가는 팽이다. 출근 때보다 시간 여유가 있어 조금 더 뚱뚱하고, 그 안에 18:10의 하천 산책로와 18:30의 상업가로가 들어간다.
지하철까지 고려하면 모양은 더 달라진다. 지하철은 역과 역 사이를 빠르게 건너뛰게 해 주기 때문에, 팽이의 그림자는 매끈한 타원이 아니라 역 주변으로만 부풀고 노선을 따라 길게 늘어난 모양이 된다.
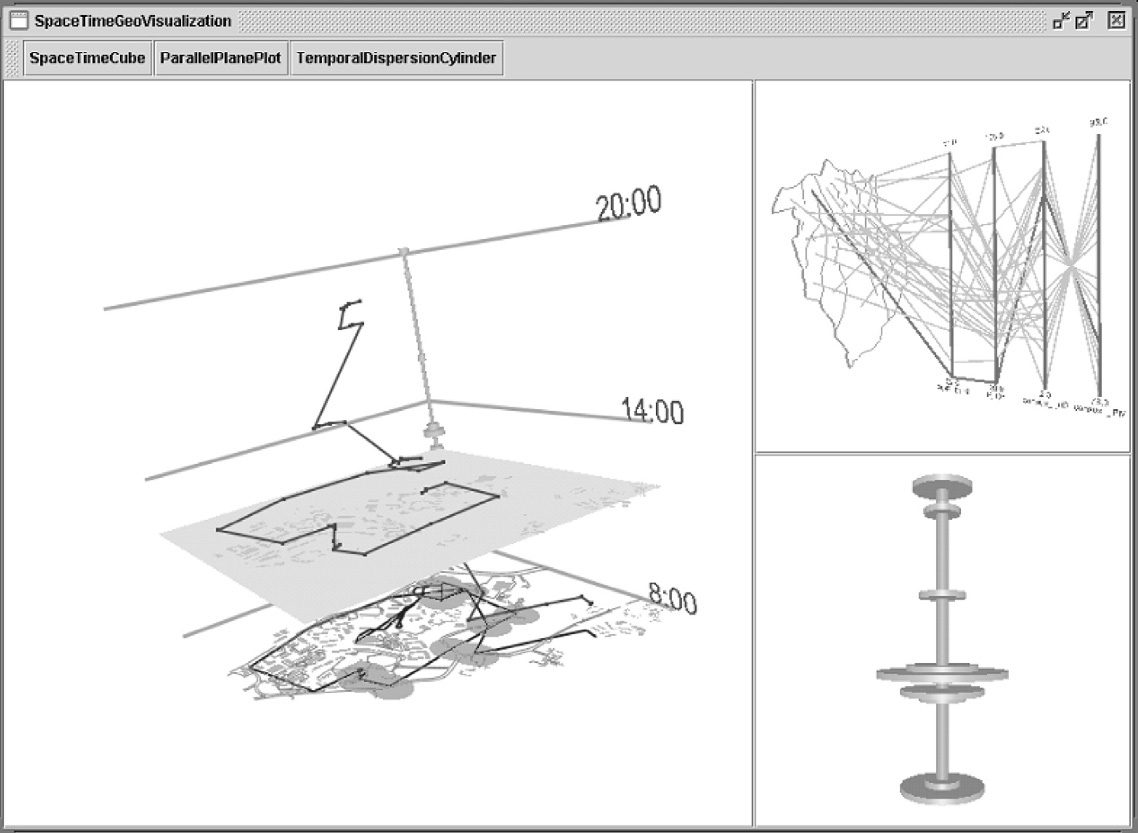시간지리학 연구의 시공간 큐브 시각화 도구: 도시 지도 위의 시간 평면(8:00, 14:00, 20:00)과 시공간 경로(좌), 평행평면그림(우상), 시간산포기둥(우하) (출처: 박기호·안재성·이양원, 2005, 『대한지리학회지』 40권 3호)
## 정리
집 앞 500m에 있는 공원이나 도서관을 평일 낮에 쓰기 어려운 이유가 여기서 바로 나온다. 그 시간대의 팽이는 이미 회사 위에 서 있다. 공원은 집에서 가깝지만 낮 12시 30분의 팽이 안에는 들어 있지 않다.
1966년의 계획은 초점이 하나인 원을 기준으로 시설을 배치했다. 2026년의 시민은 초점이 둘인 타원 위에서 산다. 2018년에 지도 위에서 구했던 타원은, 시간축을 세우고 보니 하루라는 기울어진 팽이의 그림자였다.
---
# 경제는 커졌다는데 왜 작년보다 팍팍할까? — 체감 경기를 가르는 A구간과 B구간
*Published on 2026-11-03 by canard | Category: 연구 & 비평*
**URL**: https://mixedlog.com/archives/2106
---
플러스 성장 속에서도 새로 구워지는 빵이 직전보다 줄어드는 순간, 그해(그 분기)의 신호등은 A구간에서 B구간으로 바뀐다
## 플러스 성장이라는데, 왜 작년보다 팍팍할까
해마다, 혹은 분기마다 나오는 경제 뉴스를 보다 보면 묘한 위화감이 들 때가 있다. 뉴스에서는 “이번에도 플러스 성장을 달성했다”, “실질 GDP가 역대 최고치를 또 경신했다”고 말한다. 마이너스 성장을 한 것도 아니고, 나라 전체 살림 규모는 분명 작년보다 더 커졌다.
그런데 거리와 직장에서 느끼는 공기는 다르다. 기업의 신규 채용 문은 작년보다 좁아졌고, 연봉 협상 테이블은 더 얼어붙었으며, 세금이나 연금·예산을 둘러싼 다툼은 유독 날카롭다. 경제는 커졌다는데 왜 사람들이 체감하는 일상은 “작년보다 올해가 더 팍팍하다”고 느껴질까.
경제는 성장했는데도 왜 성장의 성과가 예전처럼 체감되지 않을까? 그 이유를 모두 설명할 수는 없지만, **GDP 증가액의 변화에서 하나의 중요한 단서**를 찾을 수 있다. 물가나 분배 구조의 영향도 크지만, 그 기저에는 아주 단순한 산수가 하나 놓여 있기 때문이다. 경제의 전체 파이는 여전히 커지고 있지만, 전년과 비교했을 때 **새로 늘어나는 파이의 크기는 오히려 작아지는 시기**가 존재한다.
예금 통장으로 바꿔 보면 바로 이해된다. 통장에 **1,000만 원**이 들어 있을 때 금리가 **5%**면 1년 뒤 이자로 **50만 원**을 받는다. 몇 년 동안 돈을 더 모아 원금이 **1,500만 원**으로 불어났다고 하자. 통장 잔고는 역대 최고다. 하지만 그사이 금리가 **2%**로 떨어졌다면 올해 손에 쥐는 새 이자는 **30만 원**뿐이다. 원금은 1.5배로 커졌는데, 올해 새로 쓸 수 있는 용돈은 예전보다 20만 원이나 줄어들었다.
국가 경제도 똑같다. 경제는 시간이 갈수록 덩치가 커지지만 성장률(속도)은 오르내린다. 매해, 매 분기마다 **‘커진 덩치가 밀어 올리는 힘’**과 **‘낮아진 성장률이 깎아 먹는 힘’**이 줄다리기를 벌인다. 그리고 직전 기간과 비교한 이 줄다리기의 승패에 따라 그 시점의 경제는 공기가 전혀 다른 두 상태, 즉 **A구간**과 **B구간**으로 나뉜다. 앞선 글([「GDP와 파이의 역설」](https://mixedlog.com/archives/2035))에서 미분 수식과 거시경제 모형으로 다뤘던 이야기를, 이번에는 복잡한 기호를 덜어내고 **매년·매 분기 켜지는 A구간과 B구간의 신호등**으로 쉽게 다시 풀어 본다.
## A구간: 성장률은 떨어져도 새로 생기는 파이는 커지는 해
흔히 “올해 성장률이 작년보다 떨어졌다”는 말을 들으면 새로 늘어나는 돈도 당연히 줄었을 거라고 생각하기 쉽다. 하지만 꼭 그렇지 않다. 성장률이 완만하게 내려갈 때는 **커진 덩치가 속도 감소를 이긴다.** 이때 켜지는 초록불이 바로 **A구간(덩치 완충 구간)**이다.
계산은 곱셈 하나면 충분하다. 한 해 동안 경제에 새로 늘어나는 파이는 **(작년 경제 덩치) × (올해 성장률)**이다.
- **작년:** 경제 규모 **1,000조 원**인 나라가 **4.0%** 성장했다. 그해 새로 생긴 파이는 **+40.0조 원**이고, 덕분에 올해 초 경제의 기초 덩치는 **1,040조 원**으로 커졌다.
- **올해(A구간):** 성장률이 4.0%에서 **3.9%**로 내려갔다. 뉴스에는 “성장률 둔화”라는 제목이 달린다. 하지만 올해 새로 생긴 파이를 계산해 보면 1,040조 원 × 3.9% = **+40.56조 원**(약 **+40.6조 원**)이다.
성장률 숫자는 분명 떨어졌는데, 사회 전체에 새로 풀린 돈과 생산물은 작년(+40.0조 원)보다 오히려 **5,600억 원 더 많아졌다.** 작년에 불어난 40조 원의 덩치가 쿠션처럼 성장률 하락을 받아 낸 덕분이다. (성장률이 작년보다 아예 올라간 해에는 물론 더욱 넉넉한 A구간이 된다.)
해당 연도나 분기가 A구간에 있을 때는 뉴스가 “성장률이 둔화됐다”고 걱정해도 현장의 체감은 꽤 버틸 만하다. 새로 구워져 나오는 빵의 개수가 직전 기간 이상으로 유지되거나 더 늘어나기 때문에, 누군가의 기존 몫을 빼앗지 않고도 신규 채용을 유지하고 임금과 복지를 조금씩 늘릴 여유가 남는다.
## B구간: 플러스 성장인데도 새로 생기는 파이가 쪼그라드는 해
그렇다면 언제 갑자기 “작년보다 팍팍하다”는 체감이 찾아올까. 성장률이 떨어지는 폭이 너무 커서 **커진 덩치의 쿠션이 뚫리는 해(또는 분기)**다. 이때 켜지는 경고등이 **B구간(감속 지배 구간)**이다.
방금 본 1,040조 원 경제에서 올해 성장률이 3.9%가 아니라 **3.5%**로 내려앉았다고 해 보자. 1,040조 원 × 3.5% = **+36.4조 원**이다. 마이너스 성장을 한 게 아니다. 엄연히 +3.5% 플러스 성장을 했고, 나라 전체 GDP도 1,040조 원에서 1,076.4조 원으로 사상 최고치를 갈아치웠다. **하지만 올해 사회에 새로 풀린 파이는 작년(+40.0조 원)보다 3.6조 원이나 줄어들었다.**
> **[인포그래픽 시각화 다이어그램]** 두 경우 모두 올해 플러스 성장을 했고 전체 경제 규모도 역대 최대를 찍었지만, 새로 구워져 나오는 파이의 크기는 A구간(+40.6조 원)에서는 작년보다 늘어나고 B구간(+36.4조 원)에서는 작년보다 줄어든다.
여기서 우리는 한 가지 흥미로운 질문과 마주한다. **수학적으로 보면 GDP가 늘어나더라도 증가액은 줄어들 수 있다는 사실은 명백하다. 그렇다면 이 증가액의 둔화가 현실에서 사람들이 느끼는 경제적 답답함과도 연결될 수 있을까?**
*여기부터는 수학적으로 증명된 사실이 아니라, 그 사실에서 출발한 나의 경제적 해석이자 가설이다.*
경제의 전체 파이는 여전히 커지고 있다. 하지만 전년과 비교했을 때 새로 늘어나는 파이의 크기는 오히려 작아질 수 있다. 물론 GDP는 매년 생산되는 부가가치의 흐름(Flow)이므로, ‘기존 GDP는 이미 주인이 정해져 있고 증가액만 새로 나눌 수 있는 몫’이라고 실제 경제 구조를 단순화할 수는 없다. 사람들의 생활수준에는 가계의 실질소득과 물가, 분배 구조, 세금, 고용 환경 등이 복합적으로 작용하기 때문이다(실제로 OECD 등 주요 기관에서도 GDP 성장과 실질 가계소득의 궤적이 괴리될 수 있음을 지적한다).
그럼에도 불구하고 ‘새로 늘어나는 파이’라는 비유는, 경제의 확장 속도가 둔화되는 상황을 직관적으로 보여주는 유용한 관찰 틀이 된다. 매년 새롭게 추가되는 부가가치의 폭이 축소되는 시기에는 신규 채용이나 보상 확대 등 성장의 여력이 빡빡해질 수 있고, 그 과정에서 한정된 여력을 둘러싼 분배 논의나 체감 경기가 더 예민해질 수 있다는 문제의식이다.
## 저성장 국가의 함정: 2% 경제의 쿠션은 종잇장처럼 얇다
그해가 A구간이 될지 B구간이 될지 가르는 커트라인은 어디에서 정해질까. 원리는 간단하다. 직전 기간에 경제 덩치가 4% 커졌다면, 이번 기간의 성장률이 원래 성장률에서 약 4% 비율 이상 깎이지 않아야 직전만큼의 새 파이(+40조 원)를 지킬 수 있다(4.0% ÷ 1.04 = 3.85%).
이 단순한 산수에서 저성장 국가가 겪는 까다로운 함정이 드러난다. **기초 성장률이 낮은 나라일수록 A구간을 지켜 주는 ‘덩치 쿠션’ 자체가 종잇장처럼 얇아진다**는 점이다.
| 경제 단계 | 직전 성장률 | A구간을 지키는 이번 커트라인 | A구간이 버텨 주는 여유 폭 (쿠션 두께) |
| --- | --- | --- | --- |
| 고성장 경제 | 10.0% | 9.09% 이상 | 0.91%p 하락까지 방어 (두꺼운 쿠션) |
| 중성장 경제 | 4.0% | 3.85% 이상 | 0.15%p 하락까지 방어 (얇아진 쿠션) |
| 저성장 경제 | 2.0% | 1.96% 이상 | 0.04%p 하락까지 방어 (종잇장 쿠션) |
10%로 달리는 신흥국은 한 해에 덩치가 10%나 불어나기 때문에 쿠션이 두껍다. 이듬해 성장률이 10.0%에서 9.2%로 0.8%p나 뚝 떨어져도 여전히 A구간에 머물며 새 파이가 작년보다 더 커진다. 반면 2%로 성장하는 성숙 경제는 1년 동안 불어난 덩치 쿠션이 2%밖에 되지 않는다(분기 성장률 0.5% 기준으로는 쿠션이 0.0025%p에 불과하다). 수출이나 내수가 살짝 흔들려 연간 성장률이 2.0%에서 1.9%로 **단 0.1%p만 내려앉아도** 곧장 B구간 불이 켜진다. 저성장 선진국일수록 매해·매 분기 B구간의 찬바람을 훨씬 자주 맞을 수밖에 없는 구조다.
## A와 B는 10년짜리 이름표가 아니라 ‘매년·매 분기’ 켜지는 신호등이다
여기서 꼭 짚고 넘어가야 할 점이 있다. **A구간과 B구간은 10년 단위로 뭉뚱그려 붙이는 고정된 이름표가 아니라, 매년(또는 매 분기) 직전 기간과 비교해 판정하는 실시간 신호등**이라는 사실이다.
현실 경제는 매끈한 직선으로 움직이지 않는다. 수출 선적이 몰리는 분기도 있고, 금리나 유가가 출렁이는 해도 있다. 그래서 고성장하던 1980~1990년대 한국 경제에도 경기가 숨을 고르는 해(1989년, 1992년)에는 어김없이 B구간이 켜졌고, 반대로 저성장기인 요즘에도 반등하는 해나 분기에는 A구간이 켜진다. 특히 **분기 단위**로 보면 계절 요인이나 일시적 충격 때문에 1~2개 분기쯤 B구간에 들어서는 일은 아주 흔하다.
따라서 **“이번 분기(또는 올해) B구간이 켜졌다”는 사실 하나만으로 나라 경제의 엔진이 고장 났다고 단정할 수는 없다.** 건강한 경제라도 2~4개 분기(1년 남짓) 비를 피하러 B구간을 통과한 뒤 다시 A구간으로 힘차게 복귀한다면 아무 문제가 없다.
무엇보다 **A·B구간은 경기의 좋고 나쁨이나 살림살이의 개선·악화를 판정하기 위한 절대적 분류가 아니다.** 경제가 성장하는 과정에서 생산 증가액이 어떤 패턴으로 움직이는지를 살펴보는 ‘관찰 도구’다. 이 증가액 패턴이 우리의 실제 생활과 구체적으로 어떤 관계를 맺는지는 더 깊이 살펴볼 필요가 있지만, 적어도 매년·매 분기 신호등이 쌓였을 때 나타나는 **패턴의 변화**를 읽는 유용한 렌즈가 되어 준다.
> **[인포그래픽 시각화 다이어그램]** A구간과 B구간은 해마다(또는 분기마다) 직전 기간과 비교해 켜지는 신호등이다. 2013~2017년에는 B구간이 1년(2015년)만 켜지고 곧바로 A구간으로 복귀한 반면, 2018년 이후에는 8년 중 6번 B구간이 켜졌고 평시 반등(2024년 +377억 달러) 높이도 이전보다 낮아졌다.
실제 한국 경제의 최근 13년(2013~2025년, 세계은행 WDI 2015년 불변 달러 기준)을 해마다 직전 연도와 비교해 A·B 신호등을 찍어 보면 그 차이가 한눈에 들어온다.
- **2013~2017년의 리듬 (A · A · B · A · A):** 5년 중 4번이 A구간이었다. 특히 **2014년**은 성장률이 직전 해 3.3%에서 3.2%로 살짝 내려갔는데도 커진 덩치 쿠션이 감속을 막아 내며 새 파이가 +462억 달러에서 +466억 달러로 오히려 커졌다. 2015년에 한 차례 B구간을 거쳤지만 딱 1년 만에 A구간으로 복귀해 2017년(+545억 달러)까지 새 파이를 계속 키웠다.
- **2018~2025년의 리듬 (B · B · B · A · B · B · A · B):** 2%대 저성장으로 쿠션이 얇아지면서 풍경이 완전히 달라졌다. **8년 중 6번이나 B구간** 불이 켜졌고, 한 번 B구간에 들어가면 2~3년 연속 머무는 일이 잦아졌다. 더 눈여겨볼 대목은 A구간이 다시 켜졌을 때의 높이다. 코로나 역성장(-0.7%) 직후의 기저효과 반등(2021년)을 제외하면, 2024년에 모처럼 A구간(+377억 달러)이 켜졌을 때도 예전 평시 A구간(2016~2017년 +488억~+545억 달러)의 높이를 회복하지 못한 채 이듬해(2025년 +193억 달러) 다시 B구간으로 내려앉았다.
## 나쁜 B구간을 가려내는 세 가지 눈금과 인구 체크
결국 매 분기나 매년 성적표가 발표될 때, 그것이 자연스러운 숨고르기(혹은 성숙한 선진국이 되면서 겪는 자연스러운 감속)인지 아니면 기초 체력이 깎이는 진짜 침체 신호인지는 아래 세 가지 눈금으로 가려낼 수 있다.
- **빈도 (얼마나 자주 켜지는가):** 최근 몇 년, 혹은 최근 열 몇 개 분기의 기록표에서 A보다 B가 압도적으로 자주 찍히기 시작했는가?
- **지속성 (얼마나 오래 머무는가):** 2~4개 분기(1년 안팎) 숨을 고르고 곧장 A로 복귀하는가, 아니면 몇 년 연속 B구간에 갇혀 있는가?
- **회복 탄력 (A가 켜졌을 때 깎인 몫을 되찾는가):** 불황기에 문을 닫은 회사와 일자리를 잃은 숙련 인력이 경기 회복 뒤에도 돌아오지 못하면(경제학에서는 흉터가 남는다는 뜻으로 **이력 현상**이라 부른다), 간신히 A구간 반등이 찾아와도 예전 높이를 되찾지 못하고 B구간이 갉아먹은 폭이 A구간이 채운 폭보다 점점 더 커진다.
여기에 한국처럼 **인구가 줄어드는 나라**라면 매년 성적표를 볼 때 한 가지만 더 떼어 보면 된다. 나라 전체의 파이는 **(일하는 사람 수) × (1인당 만들어 내는 가치)**다. 일하는 사람 수가 줄어 나라 전체 성적표에 B구간이 자주 켜지더라도, **1인당 새로 만들어 내는 가치(1인당 증가액)가 매년 A구간을 자주 켜며 버티고 있다면** 기술과 생산성은 여전히 건강하게 전진하고 있다는 뜻이다. 반대로 1인당 성적표에서마저 B구간이 일상이 되고 반등 높이가 낮아진다면, 그때는 인구 핑계를 넘어 기술 혁신과 일하는 방식 자체를 고쳐야 한다는 경고등이다.
## 경제가 커져도 왜 우리는 팍팍함을 느낄까?
GDP가 늘어난다는 사실과 그 증가액이 매년 커진다는 사실은 서로 다르다.
경제가 성장하고 있어도 어느 순간부터 GDP 증가액은 줄어들 수 있다. 나는 이 지점을 흥미롭게 생각했다. 우리는 흔히 경제가 성장하면 그만큼 새로운 기회도 계속 확대될 것이라고 기대한다. 하지만 성장이 이어지더라도 증가액이 줄어드는 상황이라면 그 기대와 실제 경제의 모습 사이에 차이가 발생할 수 있다.
물론 GDP 증가액이 가계에 새롭게 분배되는 소득을 의미하는 것은 아니다. 또한 증가액 감소만으로 사람들이 더 가난해졌다고 결론 내릴 수도 없다.
그럼에도 이런 질문을 던져볼 가치는 있다.
**
“성장률이 양수라는 사실만으로 우리는 경제가 얼마나 활발하게 확장되고 있는지 충분히 이해할 수 있을까?”**
그리고 GDP 증가액의 둔화가 지속되는 시기에는 고용과 임금, 소비, 가계소득에도 특정한 변화가 나타나는 것은 아닐까? 이것은 아직 결론이 아니라 관찰에서 출발한 가설이다. 어쩌면 우리가 느끼는 경제적 답답함을 이해하기 위해 성장률 외에 함께 살펴야 할 지표가 하나 더 있는지도 모른다.
앞으로 발표될 분기·연간 성장률 뉴스를 읽을 때도 이 관점은 유효하다. 복잡한 수식 대신 다음 두 가지 질문을 던져보는 것만으로도 숫자가 가린 경제의 결을 읽어낼 수 있다.
- **첫째,** 이번 기간의 성장률은 커진 덩치가 감속을 막아 내는 **‘A구간(증가액 확대)’**에 있는가, 아니면 매년 새로 추가되는 부의 증분이 줄어드는 **‘B구간(증가액 둔화)’**에 있는가?
- **둘째,** 최근 몇 년간의 신호등을 나란히 놓았을 때 B구간은 일시적인 숨고르기인가, 아니면 반등 높이를 낮추며 점점 더 자주, 길게 지속되고 있는가?
**거시경제 심층 분석 및 실증 연재 읽기**
- [**GDP와 파이의 역설: 경제는 커지는데 왜 새로 늘어나는 몫은 줄어드는가?**](/archives/2035): A구간과 B구간의 판별 조건과 미분 수학적 증명, 솔로우 성장 회계와 장기정체(Secular Stagnation) 이론을 체계적으로 다룬 원론 논고입니다.
- [**추격의 기하학 (1): 동남아는 정말 한국을 따라잡고 있는가?**](/archives/2041): 성장률과 절대 증가액의 괴리가 국가 간 추격(Catch-up) 경쟁에서 어떻게 나타나는지 한·일 66년 통계와 한국·아세안 6개국 데이터를 통해 실증한 8주 연속 기획입니다.
---
# GDP와 파이의 역설: 경제는 커지는데 왜 새로 늘어나는 몫은 줄어드는가?
*Published on 2026-11-02 by | Category: 연구 & 비평*
**URL**: https://mixedlog.com/archives/2035
---
덩치는 커졌는데 새로 구워내는 몫은 줄어드는 기하학적 역설, 그리고 단순한 성장률 감속과 진짜 구조적 침체를 가르는 거시경제학적 진단 틀
## 들어가며: 덩치는 커지는데 배분할 몫이 줄어드는 역설
한 나라의 경제 규모가 과거보다 훨씬 커졌음에도 불구하고, 매년 새롭게 추가되는 실질 생산량의 물리적·절대적인 크기는 오히려 줄어들 수 있을까?
직관적으로는 언뜻 모순처럼 느껴진다. 경제라는 거대한 공장의 기초 체급(GDP)이 1,000조 원에서 1,500조 원으로 불어났다면, 설령 성장 속도가 다소 느려지더라도 매년 새롭게 찍어내는 부의 덩어리 자체는 더 커져야 할 것만 같다. 그러나 결론부터 말하자면 **절대 증분이 감소하는 현상은 거시경제 동학에서 성장률 감속 폭이 특정 임계치를 넘을 때 매우 빈번하게 관찰된다.**
경제의 기초 규모(\(Y\))가 커지더라도, 여기에 곱해지는 성장률(\(g\))이 그보다 더 가파른 속도로 하락한다면 한 해 동안 경제 전체에 새롭게 늘어나는 부(실질 GDP 절대 증가액 \(\Delta Y = g \cdot Y\))는 과거의 호황기보다 도리어 위축된다. 빵집의 오븐과 매장은 두 배로 넓어졌는데, 새로 구워내어 손님들에게 나누어줄 수 있는 신선한 빵의 개수는 작년보다 줄어드는 기하학적 역설이다. 물론 GDP는 매년 생산되는 부가가치의 흐름이며 증가액 자체가 유일한 분배 재원인 것은 아니지만, 성장의 확장 여력이 둔화되는 국면을 직관적으로 보여주는 유용한 비유가 된다. 이 순간부터 사회는 팽창의 여유를 잃고, 한정된 증분을 둘러싼 세대 간·계층 간 분배 갈등이라는 거친 마찰음에 직면하기 쉽다.
그러나 여기서 더 본질적인 질문이 고개를 든다. **매년 추가되는 실질 생산량의 절대 증가액이 감소하기 시작했다는 사실이, 곧바로 그 나라 경제의 기초 체력—즉 ‘구조적 잠재 성장동력’이 영구히 훼손되었다는 파국의 증거일까?**
반드시 그렇지는 않다. 그것은 자본 축적과 성숙화에 따른 자연스러운 수렴 현상일 수도 있고, 일시적인 경기순환 충격에 불과할 수도 있으며, 심각한 총요소생산성 정체나 인구 절벽이 초래한 장기정체(Secular Stagnation)일 수도 있다. 이 질문에 답하기 위해서는 직관적 관찰을 넘어, 성장률과 절대 증가액 사이의 엄밀한 수학적 조건, 경기순환과 추세의 분리, 그리고 인구와 생산성의 기여도를 분해하는 정밀한 분석 틀이 필요하다.
## 1. 성장률과 절대 증가액의 역학: 수학적 조건 도출
경제성장을 평가할 때 언론과 정책 당국이 가장 흔히 사용하는 지표는 백분율로 표시되는 ‘실질 GDP 성장률(\(g\))’이다. 그러나 성장률은 경제가 팽창하는 **‘상대적 속도(Velocity)’**를 나타낼 뿐, 한 사회가 1년 동안 실제로 얼마나 많은 실질 생산물을 더 만들어냈는가 하는 **‘물리적 부의 절대 증분(Absolute Increment)’**을 직접 보여주지는 않는다.
### 1.1 이산시간(Discrete-Time)에서의 기본 관계
\(t\)기의 실질 GDP를 \(Y_t\), 전년 대비 실질 성장률을 \(g_t \equiv \frac{Y_t - Y_{t-1}}{Y_{t-1}}\)라고 정의하면, 해당 연도에 순수하게 추가된 실질 생산량의 절대 증가액 \(\Delta Y_t\)는 다음과 같이 표현된다.
$$\Delta Y_t = Y_t - Y_{t-1} = g_t \cdot Y_{t-1}$$
로그 차분 성장률 \(\tilde{g}_t = \ln Y_t - \ln Y_{t-1}\)을 사용할 경우 엄밀한 관계식은 \(\Delta Y_t = Y_{t-1} (e^{\tilde{g}_t} - 1)\)이지만, 통상적인 거시 성장률 구간에서는 \(e^{\tilde{g}_t} - 1 \approx \tilde{g}_t\)이므로 위의 선형 곱셈 관계가 극히 높은 정밀도로 성립한다. 즉, **매년 추가되는 실질 생산물의 양은 ‘기존 경제 규모(규모 효과, Scale Effect)’와 ‘당해 성장률(속도 효과, Speed Effect)’의 곱**으로 결정된다.
다음의 대표적인 가상 시계열을 살펴보자.
| 구분 | 기초 실질 GDP (\(Y_{t-1}\)) | 당해 실질 성장률 (\(g_t\)) | 연간 실질 GDP 절대 증분 (\(\Delta Y_t\)) |
| --- | --- | --- | --- |
| 시점 ① (도약기) | 1,000조 원 | 5.0% | +50조 원 |
| 시점 ② (성숙 진입) | 1,200조 원 | 3.0% | +36조 원 |
| 시점 ③ (성숙 안정) | 1,500조 원 | 2.0% | +30조 원 |
경제 규모는 1,000조 원에서 1,200조 원, 다시 1,500조 원으로 \(+50\%\)나 팽창했다. 하지만 매년 새로 구워내는 파이의 절대 크기는 50조 원에서 36조 원, 나아가 30조 원으로 \(40\%\)나 쪼그라들었다. 이 역설적인 관계를 시각화하면 아래와 같다.
> **[인포그래픽 시각화 다이어그램]** 총 GDP 규모(선 그래프)는 꾸준히 우상향하지만, 성장률 급락으로 인해 매년 새로 추가되는 실질 증분(막대 그래프)은 50조에서 30조로 지속 하락한다.
위 그림 1이 명쾌하게 보여주듯, 전체 경제가 1,000조 원에서 1,500조 원으로 \(+50\%\)나 확장했음에도 불구하고 연간 절대 증분이 50조 원에서 30조 원으로 \(40\%\) 축소된 원인은, **‘성장률이 깎여 나간 감속 폭(\(-60\%\), \(5.0\% \to 2.0\%\))’이 ‘경제 규모가 커진 확대 폭(\(+50\%\))’을 완전히 압도했기 때문**이다. (시점 ①→② 구간만을 보더라도 규모 확대 폭 \(+20\%\)에 비해 성장률 감속 폭 \(-40\%\)가 더 커서 증분이 \(28\%\) 줄어든다.)
### 1.2 절대 증가액이 감소하기 위한 엄밀한 임계 조건 (수학적 증명)
그렇다면 성장률이 얼마나 빨리 떨어져야 기존 경제 규모 효과를 이기고 절대 증가액 감소(\(\Delta Y_{t+1} < \Delta Y_t\))를 유발할까? 이를 이산시간과 연속시간 두 가지 관점에서 수식으로 증명해 보자.
**[이산시간 조건]****다음 기의 절대 증가액 \(\Delta Y_{t+1} = g_{t+1} Y_t = g_{t+1} Y_{t-1}(1 + g_t)\)가 전기 증가액 \(\Delta Y_t = g_t Y_{t-1}\)보다 작아질 조건은 다음과 같다.
$$g_{t+1} Y_{t-1}(1 + g_t) < g_t Y_{t-1}$$
양변을 양수 조건인 \(Y_{t-1} > 0\) 및 \(g_t > 0\)로 나누어 정리하면 아래의 핵심 부등식을 얻는다.
$$\frac{g_{t+1}}{g_t} < \frac{1}{1 + g_t} \iff \frac{g_t - g_{t+1}}{g_t} > \frac{g_t}{1 + g_t}$$
이 부등식의 좌변은 ‘성장률 자체의 상대적 감속률(Deceleration Rate of Growth)’**이며, 우변은 기초 경제 대비 당기 성장 비중이다. 예컨대 현재 4%(\(g_t = 0.04\))로 성장하는 경제라면 우변의 임계치는 \(\frac{0.04}{1.04} \approx 3.85\%\)가 된다. 즉, 다음 해의 성장률이 기존 성장률 대비 **상대적으로 \(3.85\%\) 이상 하락**(즉, \(4.0\% \to 3.846\%\)로 단 \(0.154\%p\)만 하락)하여 \(3.846\%\) 미만으로 내려앉아도, 총 GDP는 늘어났음에도 연간 절대 생산 증분은 전년보다 감소하기 시작한다.
**[연속시간 조건: 성장 가속도 공식]****시간 \(t\)에 대한 연속 미분가능 함수 \(Y(t)\)와 순간 성장률 \(g(t) \equiv \frac{\dot{Y}(t)}{Y(t)}\)를 상정하자. 절대 증가 속도는 1차 미분인 \(\dot{Y}(t) = g(t) Y(t)\)다. 매년 새로 생겨나는 절대 증분이 줄어든다는 것은 거시경제의 2차 미분인 성장 가속도가 음수**가 됨을 뜻한다(\(\ddot{Y}(t) < 0\)).
곱의 미분법(Product Rule)을 적용하면 다음과 같다.
$$\ddot{Y}(t) = \frac{d}{dt}\left[ g(t) Y(t) \right] = \dot{g}(t) Y(t) + g(t) \dot{Y}(t)$$
\(\dot{Y}(t) = g(t)Y(t)\)를 대입하면,
$$\ddot{Y}(t) = Y(t) \left[ \dot{g}(t) + g(t)^2 \right]$$
\(Y(t) > 0\)이므로, 절대 증분이 감소할(\(\ddot{Y}(t) < 0\)) 필요충분조건은 놀랍도록 우아한 단 하나의 부등식으로 귀결된다.
$$\dot{g}(t) + g(t)^2 < 0 \iff -\frac{\dot{g}(t)}{g(t)} > g(t)$$
**“성장률의 상대적 감속 속도(\(-\dot{g}/g\))가 현재의 경제성장률(\(g\)) 자체를 초과할 때, 파이의 절대적 증분은 위축된다.”**
이 수식은 중대한 통찰을 담고 있다. 경제가 성숙해져 현재 성장률 \(g\)가 낮아질수록, 우변의 문턱값 역시 낮아진다. 즉, **저성장 국면에 접어든 성숙 경제일수록 아주 미세한 감속 충격만으로도 손쉽게 절대 증분 축소 구간으로 미끄러져 들어가는 구조적 취약성**을 갖게 된다.
## 2. 절대 증가액 감소를 낳는 두 가지 상반된 경로
그렇다면 현실 경제에서 \(\ddot{Y}(t) < 0\) 현상이 발생했을 때, 이를 무조건 ‘성장동력의 종말’이나 ‘시스템적 위기’로 단정해야 할까? 그렇지 않다. 동일한 수식적 결과 이면에는 **질적으로 완전히 상반된 두 가지 경제적 메커니즘**이 존재하기 때문이다.
### 2.1 성숙화의 자연스러운 수렴: '성공의 대가'
첫 번째 경로는 경제가 고소득 단계로 진입하면서 나타나는 정상적인 성숙화 과정이다. 고전적 신고전학파 성장이론(Solow, 1956)이 잘 설명하듯, 생산함수는 1차 동차이며 개별 생산요소에 대해 한계생산 체감(\(f''(k) < 0\))의 법칙이 지배한다. 자본이 희소했던 개발도상국 시절에는 기계 한 대, 공장 한 동을 추가할 때마다 폭발적인 성장을 누린다.
그러나 자본 축적(Capital Deepening)이 진척되어 1인당 자본량이 정상상태(Steady-state) 균형에 다가갈수록, 자본 1단위 투입으로 얻는 추가 산출물은 자연스럽게 줄어들며 장기 균형점(기술진보율과 인구증가율의 합, \(g^* = x + n\))으로 수렴한다. 이 이행 동학(Transitional Dynamics) 과정에서 자본 축적 속도가 둔화되며 \(\dot{g} < -g^2\) 조건이 충족되면 연간 절대 생산 증분 \(\Delta Y_t\)가 줄어들 수 있다. 그러나 이것은 병리적 쇠락이 아니라, **가난에서 벗어나 고소득 선진국에 안착하면서 치르는 ‘성공의 대가(Penalty of Success)’**다.
### 2.2 잠재 엔진의 구조적 추락: 장기정체(Secular Stagnation)
정반대의 극단에는 경제의 기초 체력인 잠재성장률 곡선 자체가 밑바닥으로 추락한 **‘장기정체(Secular Stagnation)’**의 경로가 있다(Hansen, 1939; Summers, 2014). 이는 정상상태로의 평온한 안착이 아니라, 공급과 수요의 복합적 기능부전이 낳은 치명적 상태다.
- **공급 측면의 총요소생산성(TFP) 정체**: 과거 전력망·내연기관 등 실물 경제 전반을 뒤흔들었던 산업혁명과 달리, 현대의 디지털 혁신은 오락적 편익은 높일지언정 사회 전반의 물리적 생산성 도약을 이끌어내지 못한다는 고질적 의구심(Gordon, 2016)과 맞닿아 있다. 여기에 좀비기업 연명과 규제 경직성이 더해져 자원 배분의 효율성이 급격히 떨어진다.
- **수요 측면의 투자 실종과 자연이자율 하락**: 인구 고령화로 은퇴 대비 저축 성향은 폭증하는 반면, 실물 투자 수요는 메마른다. 그 결과 완전고용을 달성할 수 있는 균형 실질금리인 ‘자연이자율(\(r^*\))’이 마이너스(\(r^* < 0\))로 침강하여 통화정책이 제로 하한(ZLB)에 갇히게 된다(Summers, 2014).
이 두 경로는 겉보기에 똑같이 절대 증분 감소(\(\ddot{Y} < 0\))라는 통계적 수치를 보이지만, **성숙화에 따른 수렴은 풍요에 도달한 경제의 ‘안정적 안착’인 반면, 장기정체는 엔진이 꺼져가는 거함의 ‘구조적 탈진’**이라는 점에서 질적으로 정반대다.
## 3. 체제 판별: A구간(규모 완충)과 B구간(감속 지배)
이 메커니즘을 보다 명확히 조망하기 위해, 경제의 동학적 상태를 **A구간(규모 완충 체제)**과 **B구간(감속 지배 체제)**이라는 두 가지 체제(Regime)로 범주화할 수 있다.
### 3.1 A구간: 규모 효과가 감속을 상쇄하는 영역 (\(\ddot{Y} \ge 0\))
성장률이 다소 둔화되더라도(\(\dot{g} < 0\)), 그 하락 폭이 완만하여 경제 규모 팽창의 힘이 감속의 손실을 거뜬히 방어하는 구간이다. 수학적으로는 \(\dot{g} \ge -g^2\)가 성립한다. 이 구간에서 실질 GDP의 절대 증분 \(\Delta Y_t\)는 전년과 비슷하게 유지되거나 오히려 소폭 확대된다. 신규 일자리 창출과 실질 임금 상승 여력이 유지되므로, 사회는 안정적인 사회적 타협과 세수 기반을 유지할 수 있다.
### 3.2 B구간: 감속 효과가 규모를 압도하는 영역 (\(\ddot{Y} < 0\))
성장률의 하락 속도가 임계선을 넘어(\(\dot{g} < -g^2\)), 경제 체급 확대로 인한 완충력을 무너뜨리는 구간이다. 실질 GDP 절대 증가액 \(\Delta Y_t\)가 전년보다 뚜렷하게 감소한다. 새로운 부의 창출 속도가 둔화되면서 세수 확충이 정체되고, 연금 개혁과 복지 지출을 둘러싼 세대 간 제로섬(Zero-sum) 갈등이 격화되는 실물 체감이 본격화된다.
> **[인포그래픽 시각화 다이어그램]** 성장률의 상대적 감속률(-ġ/g)이 성장률(g)보다 완만하면 절대 증분이 유지되는 A구간에 머물지만, 감속 속도가 경계선을 넘어서면 절대 파이가 줄어드는 B구간으로 진입한다.
그러나 여기서 주의해야 할 점은, **B구간에 단기적으로 진입했다는 사실 하나만으로 구조적 침체라 낙인찍을 수는 없다**는 사실이다. 경기순환상 수축기에는 어느 선진 경제나 일시적으로 B구간을 통과하기 때문이다.
## 4. 구조적 침체의 진정한 징후: 빈도·지속성·이력현상
실제 거시경제는 교과서의 매끄러운 미분 곡선대로 움직이지 않는다. 호황과 불황이 교차하고, 금융 충격이나 공급망 교란 같은 외생적 변동이 끊임없이 발생한다. 따라서 일시적인 경기 후퇴로 B구간에 들어서는 것은 자연스러운 경기순환(Business Cycle)의 일환이다.
그렇다면 일시적 경기 순환과 영구적 구조 둔화를 가르는 판별 기준은 무엇인가? **핵심은 시계열의 ‘빈도’, ‘지속성’, 그리고 ‘비대칭적 이력 현상’에 있다.**
### 4.1 일시적 후퇴인가, 영구적 상흔인가: 이력 현상(Hysteresis)
외부 충격이 가해졌을 때 건강한 경제와 병든 경제를 가르는 결정적 차이는 **‘이력 현상(Hysteresis)’**의 유무에 있다(Blanchard & Summers, 1986). 물리학에서 유래한 이 개념은 충격이 사라진 뒤에도 시스템이 원래의 균형 상태로 복귀하지 못하고 영구적인 상흔(Scarring Effect)을 남기는 현상을 뜻한다.
- **지속성(Persistence)과 빈도(Frequency)**: 일시적 경기 둔화라면 2~4개 분기 후 다시 A구간으로 복귀한다. 그러나 구조적 위기에 직면한 경제에서는 10년 단위의 장기 이동평균 상에서 B구간의 출현 빈도가 압도적으로 높아지며, B구간에 머무는 기간이 수년 단위로 장기화된다.
- **회복의 비대칭성과 잠재 경로의 계단식 하향**: 건전한 경제는 불황으로 B구간을 겪더라도 반등기에 강력한 탄력성을 보이며 과거의 잠재 궤도로 복귀한다(A구간의 강력한 회복). 반면 구조적 위기에 빠진 경제는 불황기 동안 장기 실업에 따른 인적 자본 훼손(Skill Atrophy), R&D 투자 취소, 설비 해체 등으로 인해 공급 능력이 영구히 파괴된다. 그 결과 경기가 반등하더라도 과거의 궤적으로 돌아가지 못하고, **잠재성장 경로 자체가 계단식으로 영구 하향 이탈**한다.
- **B구간의 A구간 잠식**: 시간이 흐를수록 A구간에서 창출하는 잉여 증분보다 B구간에서 갉아먹는 증분의 손실 폭이 커져, 중장기 실질 증분(\(\Delta Y\)) 추세선 자체가 우하향 곡선을 그리게 된다.
## 5. 규모가 다른 국가 간 비교 시 빠지기 쉬운 통계적 착시
이 절대 증가액과 성장률의 상대적 관계는 국가 간 경제력 비교에서도 흔히 심각한 해석 오류를 낳는다.
예를 들어 GDP 100조 원인 신흥국 A가 \(6.0\%\) 고성장을 달성하면 연간 실질 증분은 \(+6\)조 원이다. 반면 GDP 2,000조 원인 성숙 선진국 B가 \(1.5\%\)의 완만한 성장에 머물더라도 연간 실질 증분은 무려 \(+30\)조 원에 달한다.
- **성장률 지표만 볼 경우**: A국(\(6\%\))이 B국(\(1.5\%\))보다 4배나 강력하고 역동적인 경제로 오인된다.
- **절대 증가액만 볼 경우**: B국(\(+30\)조)이 A국(\(+6\)조)보다 5배나 많은 실물 생산 증분을 국내외에 창출했으므로, B국이 겪고 있는 성장 감속의 구조적 위기가 거대한 체급 뒤에 은폐된다.
실제로 실증 분석에 따르면(Eichengreen, Park, & Shin, 2012), 고속 성장을 달리던 신흥국들은 통상 1인당 소득이 약 17,000달러(2005년 PPP 기준)에 도달할 때 연평균 3.5%p 수준의 급격한 ‘성장 감속(Growth Slowdown)’을 겪는다. 성장률은 **‘현재 체격 대비 팽창 속도’**를, 절대 증분은 **‘글로벌 실물 시장에 추가한 절대 볼륨’**을 나타낸다. 따라서 국가 간 비교 시에는 명목 환율 왜곡을 배제한 구매력평가(PPP) 기준 실질 GDP를 토대로 두 지표를 입체적으로 병행 조망해야만 착시를 피할 수 있다.
## 6. 인구효과 분해: 외연적 성장과 집약적 성장의 분리
총 GDP 절대 증가액 감소를 해석할 때 가장 결정적인 분석 단계는 **‘인구 요인(외연적 성장, Extensive Growth)’과 ‘1인당 생산성 요인(집약적 성장, Intensive Growth)’을 수학적으로 분리해 내는 일**이다.
총생산 \(Y_t\)를 총인구(또는 총 노동시간) \(N_t\)와 1인당 실질 생산량 \(y_t \equiv Y_t / N_t\)의 곱으로 나타내자.
$$Y_t = N_t \cdot y_t$$
로그 차분을 취하면 거시 성장률의 기본 항등식이 도출된다.
$$g_{Y,t} \approx g_{N,t} + g_{y,t}$$
나아가 연간 절대 증가액 \(\Delta Y_t = Y_t - Y_{t-1}\)을 외연적(인구) 효과와 집약적(생산성) 효과로 정확하게 대수적 분해(Exact Algebraic Decomposition, 항등식)하면 다음과 같다.
$$\Delta Y_t = \underbrace{y_{t-1} \Delta N_t}_{\text{외연적(인구) 기여분}} + \underbrace{N_{t-1} \Delta y_t}_{\text{집약적(생산성) 기여분}} + \underbrace{\Delta N_t \Delta y_t}_{\text{교차 효과}}$$
이 분해식은 총 GDP의 절대 증분이 줄어들 때 우리가 내려야 할 거시경제적 진단의 방향을 명확하게 갈라준다.
- **경우 1: 인구 절벽에 의한 절대 증가액 감소 (\(\Delta N_t < 0\), \(\Delta y_t > 0\))****
생산가능인구 감소로 인해 외연적 기여분(\(y_{t-1} \Delta N_t\))이 거대한 음(-)의 값을 가지면서 총 GDP 증가액 \(\Delta Y_t\)가 줄어드는 경우다. 그러나 1인당 생산성 증가율(\(g_{y,t}\))과 1인당 증분(\(\Delta y_t\))이 견고하게 유지된다면, 그 사회의 노동자 개개인은 여전히 더 스마트하고 혁신적으로 일하고 있는 것이다. 이는 인구학적 전환(Demographic Transition)에 기인한 물리적 규모 축소이지, 기술이나 자본 배치의 구조적 퇴행이라 볼 수 없다.
- 경우 2: 진정한 구조적 침체 (\(\Delta y_t \to 0\) 또는 \(\Delta y_t < 0\))****
총 GDP 절대 증분만 감소하는 것이 아니라, 1인당 실질 GDP의 성장률(\(g_{y,t}\))과 절대 증가액(\(\Delta y_t\))마저 동시에 하락 추세**를 그리는 경우다. 인구 감소라는 핑계 뒤에 혁신 정체, 자본투자 위축, 총요소생산성 저하라는 치명적인 병폐가 숨어 있음을 뜻한다. 경제학적으로 경계해야 할 진짜 파국의 신호는 바로 이 경우다.
### 6.1 인구 감소가 1인당 혁신 생산성마저 갉아먹는 동학적 위험
여기서 한 걸음 더 나아가 우리가 특히 경계해야 할 지점은, **인구 감소가 단순한 노동력 축소(\(\Delta N < 0\))에 그치지 않고 장기적으로 1인당 생산성(\(y_t\))의 잠재력마저 갉아먹는 2차 전이 효과**를 유발한다는 사실이다(Jones, 2022).
지식과 아이디어는 한 사람이 써도 닳지 않는 비경합성(Non-rivalry)을 갖기 때문에, 인구가 풍부할수록 새로운 기술을 개발하는 혁신가(Ideas Producers)의 풀이 넓어져 사회 전체의 기술 진보가 가속화된다. 반면 인구가 지속적으로 감소하는 사회는 연구개발 인력의 절대 규모마저 줄어들며 새로운 지식 스톡의 축적 속도가 급격히 둔화된다. 결국 외연적 인구 감소는 시차를 두고 집약적 생산성 성장(\(g_y\))마저 멈추게 만드는 치명적인 부메랑이 되어 돌아올 수 있다.
## 7. 구조적 침체 판별을 위한 4단계 진단 프로토콜
지금까지의 이론과 실증 논의를 종합하면, 특정 국가에서 실질 GDP 절대 증가액의 지속적 감소(\(\ddot{Y} < 0\))가 관찰되었을 때 경제학자가 수행해야 할 체계적인 진단 순서는 다음과 같은 4단계 프로토콜로 정리된다.
**1단계 · 추세-순환 분해 (Trend-Cycle Decomposition)**필터링 기법(HP 필터, 상태공간 모형)으로 일시적 경기 갭(\(Y_t - Y_t^*\))을 제거하고 기저의 잠재 궤도를 확인
↓
**2단계 · 인구 효과와 생산성 효과의 엄밀한 분리**총 GDP 증분 감소가 인구 감소(\(\Delta N\)) 때문인지 1인당 생산성 정체(\(\Delta y\)) 때문인지 판별
↓
**3단계 · 솔로우 성장회계(Growth Accounting) 정밀 점검**자본 축적(\(K\)), 노동 투입(\(L\)), 그리고 순수 기술 혁신인 총요소생산성(\(TFP\))의 기여도 분해 (Solow, 1957)
↓
**4단계 · B구간 지속성과 이력 현상(Hysteresis) 검증**충격 이후 잠재성장 경로가 영구적으로 계단식 하향 이탈했는지 여부 판정
*※ 계량경제학적 주의점: 1단계의 추세 분해 시 널리 쓰이는 HP 필터(Hodrick & Prescott, 1997)는 시계열의 양 끝단에서 추정치가 왜곡되는 경계치 왜곡(End-point bias)이나 인위적 가짜 순환(Spurious Cycle) 위험(Hamilton, 2018)이 있으므로, 해밀턴 회귀 필터나 칼만 필터 기반 상태공간 모형을 교차 검증 도구로 병행해야 한다.*
이 4단계를 거쳐 **총요소생산성(TFP)의 구조적 정체와 1인당 생산성 저하**, 그리고 **잠재성장률 경로의 영구적 하향 이탈**이 함께 확인될 때 비로소 우리는 “이 경제가 구조적 장기 침체에 직면해 있다”고 명확히 진단할 수 있다.
## 맺으며: 얼마나 느려졌는가가 아니라, 어떻게 느려지고 있는가
경제 규모가 커졌다고 해서 매년 창출되는 실질 생산물의 절대량까지 당연히 커져야 하는 것은 아니다. 성장률의 상대적 감속 속도가 기존 성장률 자체를 압도할 때(\(-\dot{g}/g > g\)), 경제는 전체적으로 팽창하면서도 매년 손에 쥐어지는 새로운 부의 증분은 감소하는 기하학적 역설을 겪는다.
따라서 **절대 증가액의 축소는 그 자체로 파국을 선고하는 종말의 판결문이 아니라, 경제의 구조적 속살을 뜯어보라고 명령하는 ‘정밀 진단 신호’**다.
그것이 고소득 사회가 필연적으로 맞이하는 성숙화의 자연스러운 수렴인가, 아니면 총요소생산성과 혁신의 엔진이 꺼져가는 구조적 탈진인가? 인구가 줄어서 파이가 작아 보이는 외연적 축소인가, 아니면 지식 창출의 엔진마저 식어버린 집약적 생산성의 정체인가? 결국 거시경제를 읽는 핵심 질문은 *“얼마나 느려졌는가”*라는 단편적 수치가 아니라, *“어떤 메커니즘을 거쳐 어떻게 느려지고 있는가”*를 집요하게 묻는 일에 있다.
**연계 분석 및 실증 연재 읽기**
- [**경제는 커졌다는데 왜 작년보다 팍팍할까? — 체감 경기를 가르는 A구간과 B구간**](/archives/2106): 본문의 A구간·B구간 수리 모형을 복잡한 기호 없이 통장 잔고와 분기별 신호등 비유로 쉽게 풀어낸 일상적 해설입니다.
- [**추격의 기하학 (1): 동남아는 정말 한국을 따라잡고 있는가?**](/archives/2041): 제5절에서 다룬 '규모가 다른 국가 간 성장률 착시와 절대 증가액 역학'을 한·일 66년 역사와 한국·동남아 실물 데이터로 심층 실증한 8주 연속 기획 연재입니다.
## 참고문헌 (References)
- Blanchard, O. J., & Summers, L. H. (1986). *Hysteresis and the European Unemployment Problem*. **NBER Macroeconomics Annual**, 1, 15–78. DOI: [10.1086/654013](https://doi.org/10.1086/654013)
- Eichengreen, B., Park, D., & Shin, K. (2012). *When Fast Growing Economies Slow Down: International Evidence and Implications for China*. **Asian Economic Papers**, 11(1), 42–87. DOI: [10.1162/ASEP_a_00118](https://doi.org/10.1162/ASEP_a_00118)
- Gordon, R. J. (2016). *The Rise and Fall of American Growth: The U.S. Standard of Living since the Civil War*. **Princeton University Press**. DOI: [10.1515/9781400873302](https://doi.org/10.1515/9781400873302)
- Hamilton, J. D. (2018). *Why You Should Never Use the Hodrick-Prescott Filter*. **The Review of Economics and Statistics**, 100(5), 831–843. DOI: [10.1162/rest_a_00706](https://doi.org/10.1162/rest_a_00706)
- Hansen, A. H. (1939). *Economic Progress and Declining Population Growth*. **The American Economic Review**, 29(1), 1–15.
- Hodrick, R. J., & Prescott, E. C. (1997). *Postwar U.S. Business Cycles: An Empirical Investigation*. **Journal of Money, Credit and Banking**, 29(1), 1–16. DOI: [10.2307/2953682](https://doi.org/10.2307/2953682)
- Jones, C. I. (2022). *The End of Economic Growth? Unintended Consequences of a Declining Population*. **American Economic Review**, 112(11), 3489–3527. DOI: [10.1257/aer.20201605](https://doi.org/10.1257/aer.20201605)
- Solow, R. M. (1956). *A Contribution to the Theory of Economic Growth*. **The Quarterly Journal of Economics**, 70(1), 65–94. DOI: [10.2307/1884513](https://doi.org/10.2307/1884513)
- Solow, R. M. (1957). *Technical Change and the Aggregate Production Function*. **The Review of Economics and Statistics**, 39(3), 312–320. DOI: [10.2307/1926047](https://doi.org/10.2307/1926047)
- Summers, L. H. (2014). *U.S. Economic Prospects: Secular Stagnation, Hysteresis, and the Zero Lower Bound*. **Business Economics**, 49(2), 65–73. DOI: [10.1057/be.2014.13](https://doi.org/10.1057/be.2014.13)
---
# 바벨탑 아래의 지도: AI는 어떻게 언어를 배웠고, 인류는 다시 하나의 언어를 갖게 될까
*Published on 2026-10-30 by | Category: 연구 & 비평*
**URL**: https://mixedlog.com/archives/2030
---
규칙에서 벡터 공간으로 말을 배운 인공지능, 실시간 음성 번역이 가져온 변화, 그리고 인류가 오랫동안 찾아 헤맨 ‘중간언어(Interlingua)’라는 공통의 지반
## 들어가며: 번역가의 자리, 언어학의 실험실
번역가에게 요즘 자주 오는 의뢰는 처음부터 번역해 달라는 일이 아니다. 기계가 먼저 옮긴 글을 다듬어 달라는 일이다. 업계에서는 이를 **포스트에디팅(MTPE, Machine Translation Post-Editing)**이라고 부른다. 단가는 낮아지고 마감은 짧아졌다. 번역가는 글을 처음 쓰는 사람에서 기계의 초안을 검수하는 사람으로 바뀌어 가고 있다. 이제는 활자만의 이야기도 아니다. 화상회의에서는 기계가 내 목소리를 흉내 내어 상대의 언어로 말해 주고, 영상에서는 기계가 원작자의 목소리와 어조로 더빙을 입힌다. "AI가 번역을 잠식하고 있다"는 말은 더 이상 업계의 엄살로 들리지 않는다.
같은 기술을 언어학자들은 조금 다르게 본다. 대규모 언어모델(LLM)은 문법을 따로 배운 적이 없다. 다음 단어를 예측하는 훈련만 받았는데도 모델 안에서 정교한 문장 구조가 나타나고, 수십 개 언어가 하나의 고차원 의미 공간에 겹쳐진다. 언어학자들은 한 세기 가까이 사고실험과 제한된 관찰 자료만으로 세 가지 질문을 둘러싸고 논쟁해 왔다. 문법은 타고나는가, 의미는 단어가 쓰이는 방식에서 나오는가, 그리고 모든 언어 밑바닥에 공통의 구조가 존재하는가. 이제 이 질문들을 직접 확인해 볼 수 있는 장치가 생겼다. 번역가에게 AI가 일자리를 위협하는 경쟁자라면, 언어학자에게는 사상 처음으로 살아 움직이는 언어 능력의 표본을 직접 열어 볼 수 있는 거대한 실험실이다.
이 두 얼굴은 같은 사실에서 비롯된다. 기계가 언어를 진정으로 '이해'하는지는 아직 알 수 없지만, 언어와 언어 사이의 경계를 건너는 능력만큼은 분명히 얻었다. 그렇다면 기계가 건너다니는 그 공간은 도대체 무엇일까. 그리고 그 공간은 누구의 것일까.
창세기의 바벨탑 이야기에서 인류는 하나의 언어를 잃고 뿔뿔이 흩어졌다. 그 뒤로 인류는 흩어진 언어들 사이에 다리를 놓으려 끊임없이 애써 왔다. 처음에는 제국의 언어로, 다음에는 인간이 인공적으로 설계한 언어로, 이제는 기계로. 이 글은 그 다리들을 차례로 건너 본다. 기계가 언어를 배운 과정, 번역이 기계의 일이 되어 가는 현실, 인류가 공통어를 찾아온 역사를 지나, 마지막으로 그 모든 다리 밑에 깔려 있을지 모르는 지도, 곧 '중간언어(Interlingua)'에 이르는 여정이다.
## 1. 기계는 어떻게 말을 배웠나: 규칙에서 공간으로
### 1.1 규칙의 시대 (1950~1980년대)
기계와 언어의 만남은 번역에서 시작됐다. 1954년 조지타운-IBM 실험은 러시아어 문장 60여 개를 영어로 옮겨 보였다. 당시 언론은 몇 년 안에 기계번역이 완전히 완성될 것이라고 대서특필했다. 그러나 1966년 미국 과학아카데미의 ALPAC 보고서가 기계번역 연구의 성과가 기대에 미치지 못하며 단기적 실용화 전망이 불투명하다고 냉정하게 평가하면서 관련 연구비는 대폭 삭감되었다.
같은 시기 언어학계에서는 노암 촘스키(Noam Chomsky)의 생성문법이 주류로 자리 잡았다. 인간은 선천적으로 '보편문법(Universal Grammar)'이라는 생물학적 장치를 갖고 태어나며, 그렇기 때문에 어린아이가 불완전하고 적은 언어적 자극만으로도 모국어를 완벽하게 습득한다는 이론이다. 초기 인공지능 연구도 이 방향을 충실히 따랐다. 문법 규칙과 사전의 대응 관계를 논리적으로 정밀하게 기술해 컴퓨터에 입력하면 기계가 인간처럼 언어를 다룰 수 있다고 믿었다. 인간의 생각을 기호와 규칙으로 계산할 수 있다는 이 믿음은, 멀리 거슬러 올라가면 17세기 고트프리트 빌헬름 라이프니츠(Gottfried Wilhelm Leibniz)가 꿈꾸었던 '보편 기호법(Characteristica Universalis)'의 후예였다.
하지만 인간의 실제 언어는 규칙 안에 온전히 담기지 않았다. 무수한 예외와 문맥 의존성, 다의성과 중의성, 관용구가 끝없이 쏟아져 나오며 규칙 기반 시스템은 한계에 부딪혔다.
### 1.2 통계의 시대 (1980~2000년대)
다음 전환점은 언어학적 규칙을 억지로 짜 맞추는 대신 대규모 데이터에서 단어의 출현 빈도를 통계적으로 세어 보자는 발상이었다. IBM의 음성인식 연구를 이끌었던 프레더릭 옐리넥(Frederick Jelinek)이 했다고 전해지는 유명한 말이 이 시대를 상징한다.
**
“언어학자를 한 명 해고할 때마다, 우리 음성인식기의 성능이 올라간다.”
이 무렵부터 공학으로서의 자연어 처리는 전통 언어학 이론과 갈라지기 시작했다. 같은 내용을 여러 언어로 병렬 수록한 방대한 말뭉치에서 단어와 구문의 대응 확률을 계산하는 통계적 기계번역(SMT)이 규칙 기반 시스템을 압도했다. 다만 단어를 짧은 연쇄(n-gram) 단위의 기계적 빈도로만 다루었기 때문에, 긴 문장의 유기적인 통사 구조와 깊은 맥락적 의미까지는 온전히 포착하지 못했다.
### 1.3 표현의 시대 (2013~2017)
2013년 토마시 미콜로프(Tomáš Mikolov) 등이 발표한 Word2Vec은 단어를 수백 차원의 연속적인 기하학적 공간 속 '벡터(Vector)'로 바꾸어 놓았다. 이 벡터 공간에서는 다음과 같은 연산이 대략적으로 성립했다.
> 왕(King) − 남자(Man) + 여자(Woman) ≈ 여왕(Queen)**
단어의 의미가 불연속적인 기호가 아니라 공간 속의 방향과 거리, 곧 기하학적 좌표로 표현된 것이다. 이어 시퀀스-투-시퀀스(Seq2Seq, 2014), 어텐션 메커니즘(Attention, 2015), 그리고 트랜스포머(Transformer, 2017) 아키텍처가 등장하면서 기계는 낱단어를 넘어 문장과 문단 전체에 걸친 복잡한 상호관계를 단숨에 조망할 수 있게 되었다.
그리고 2016년, 구글 연구진은 흥미로운 현상을 학계에 보고했다([Johnson et al., 2017](https://doi.org/10.1162/tacl_a_00065)). 여러 언어를 함께 학습한 다국어 신경망 번역 모델이, 학습 과정에서 직접적인 병렬 데이터를 단 한 번도 본 적 없는 언어 쌍 사이의 번역을 그럭저럭 해낸 것이다. 이른바 **‘제로샷 번역(Zero-Shot Translation)’**이다. 기계가 언어 사이에 놓은 다리가 개별 언어 쌍마다 분절된 다리가 아니라, 하나의 공통된 의미 지반 위에 서 있을지도 모른다는 첫 번째 실마리였다.
### 1.4 대규모 언어모델의 시대 (2018~현재)
BERT와 GPT-3, ChatGPT로 이어진 대규모 언어모델(LLM)은 과거 규칙의 시대가 끝내 해내지 못했던 일을 자연스럽게 달성했다. 명시적인 문법 규칙을 단 한 줄도 주입하지 않았음에도, 인간보다 더 유려하고 문법적으로 완벽한 글을 써낸다. 모델의 내부 신경망 가중치를 분석한 연구자들은 놀라운 관찰 결과를 내놓았다.
- **문법은 모델 내부 공간에 자발적으로 형성되었다**: 휴잇과 매닝([Hewitt & Manning, 2019](https://doi.org/10.18653/v1/N19-1419))은 언어모델의 다차원 활성화 공간 안에서 문장의 통사 구조(구문 트리)를 기하학적 거리 측정만으로 복원해 낼 수 있음을 입증했다.
- **언어 사이의 경계가 흐려졌다**: 피레스 등([Pires et al., 2019](https://doi.org/10.18653/v1/P19-1493))이 보여주었듯, 다국어 모델은 영어 데이터로만 특정 과제를 미세조정(Fine-tuning)해도 별도의 훈련 없이 다른 수십 개 언어의 과제를 높은 정확도로 수행해 낸다.
- **언어보다 개념이 먼저 존재할 수 있다**: 최근의 기계 해석 가능성(Interpretability) 연구들은 활성화 패칭(Activation Patching) 등의 기법을 통해 트랜스포머 모델의 중간 계층에 개별 언어의 표층 어휘와 무관한 '공유 개념 표현(Language-Agnostic Conceptual Representations)'이 실재함을 확인했다(Dumas et al., 2025). 언어별 특수 처리는 주로 입력층과 출력층 부근에서 일어난다.
기계가 인간의 규칙을 하향식으로 전달받던 시대는 끝났다. 이제 기계는 언어를 다차원 공간의 지형도로 스스로 배운다. 그러자 이번에는 정반대의 현상이 벌어졌다. 한때 공학자들에게 외면받았던 언어학자들이 기계의 내부를 들여다보기 시작한 것이다.
## 2. 언어학의 실험실이 된 AI
옐리넥의 농담처럼 공학은 한때 언어학자를 내보냈다. 하지만 LLM이 등장하자 언어학자들은 다시 연구 현장으로 불려 왔다. 이번에는 기계를 설계하는 공학자가 아니라, 기계가 보여주는 경이로운 언어 능력을 해독하는 분석가로서였다. 그러나 그 해석은 하나로 모이지 않고 팽팽하게 대립하고 있다.
- **“촘스키의 가설은 반증되었다”**: 인지과학자 스티븐 피안타도시([Piantadosi, 2024](https://doi.org/10.5281/zenodo.12665933))는 LLM이 선천적인 생물학적 보편문법 장치 없이 오직 데이터로부터 통계적 상관관계를 학습하는 것만으로도 복잡한 계층적 통사 구조를 습득한다는 사실이 촘스키식 언어학의 핵심 전제를 무너뜨린다고 주장했다.
- **“그것은 진정한 언어가 아니다”**: 반면 노암 촘스키와 언어학자 이언 로버츠(Ian Roberts), 제프리 와투멀(Jeffrey Watumull)은 2023년 뉴욕타임스 공동 기고를 통해 ChatGPT는 그저 거대한 통계적 패턴 매칭 기계에 불과하며, 인간이 배울 수 있는 실제 언어와 물리적으로 배울 수 없는 불가능한 가짜 언어를 구별해 내지 못한다고 강하게 반박했다.
- **“형식만으로는 의미에 닿을 수 없다”**: 에밀리 벤더와 알렉산더 콜러([Bender & Koller, 2020](https://doi.org/10.18653/v1/2020.acl-main.463))는 ‘문어 사고실험(Octopus Test)’을 통해 기호의 형태적 연쇄(Form)만 학습하는 시스템은 현실 세계의 실체와 닿아 있는 진짜 의미(Meaning)에 도달할 수 없다고 지적했다. 벤더 등([Bender et al., 2021](https://doi.org/10.1145/3442188.3445922))은 대규모 언어모델을 ‘확률적 앵무새(Stochastic Parrots)’라 부르며 글자의 통계적 배치와 인간의 이해 사이에는 건널 수 없는 간극이 있다고 경고했다.
데이터 효율성의 차이도 여전히 극적이다. 인간 아이는 대략 수천만 단어(약 1,000만~3,000만 단어) 수준의 음성 자극을 듣고도 모국어의 문법 체계를 완벽하게 완성하지만, 최신 LLM은 수조(Trillion) 개의 텍스트 토큰을 집어삼킨 뒤에야 문법을 구사한다. 어린아이가 접하는 데이터 규모로 언어모델을 훈련시켜 그 한계를 측정해보는 ‘베이비엘엠 챌린지(BabyLM Challenge)’는 인간과 기계 사이의 이 거대한 간극을 규명하려는 시도다.
결국 AI는 언어학을 대체한 것이 아니라 언어학의 거대한 실험실이 되었다. 과거에는 책상 위에서 칠판을 보며 머릿속 사고실험으로만 다투던 가설들을 이제 컴퓨터 안에서 모델을 열고 가중치를 측정하며 검증할 수 있게 되었다. 그런데 이 실험실이 언어학자에게 전례 없는 지적 호기심을 안겨주는 동안, 언어의 현업에서 살아가는 사람들에게는 생존의 위협으로 다가왔다. 그 최전선에 서 있는 이들이 바로 번역가였다.
## 3. 번역은 기계의 일이 되는가
### 3.1 잠식론: 이미 일어나고 있는 현장의 변화
기계가 언어와 언어 사이의 경계를 수월하게 넘나들게 되자 가장 먼저 지각변동이 일어난 곳은 번역 시장이었다.
- **작업 방식의 재편**: 기업 문서, 소프트웨어 매뉴얼, 기술 규격서, 웹사이트 로컬라이제이션 같은 실용 번역 시장은 기계가 초벌 번역을 끝내고 사람이 이를 감수하는 MTPE(기계번역 후편집) 체제로 거의 전환되었다.
- **노동 가치의 절하**: 후편집은 글을 밑바닥부터 새로 짓는 창작이 아니라 단순히 '기계의 오류를 고치는 보조 노동'으로 취급되어 단가가 크게 깎인다. 그러나 실제로는 기계가 그럴듯하게 빚어낸 미묘한 오역을 잡아내는 데 초벌 번역 못지않은 피로와 고도의 주의력이 소모된다.
- **수요 자체의 증발**: 일반 사용자들도 ChatGPT나 딥엘(DeepL)을 이용해 해외 바이어와의 이메일, 논문 초록, 비즈니스 문서를 스스로 번역한다. 과거 프리랜서 번역가들에게 의뢰되던 일상의 수요 상당수가 시장에 진입조차 하지 않고 사라진다.
### 3.2 가장 최근의 장면: 구글의 실시간 음성 번역과 유튜브 자동 더빙
번역의 기계화는 텍스트 문서에 머무르지 않는다. 최근 구글의 움직임은 번역의 지평이 활자에서 음성으로, 사후 교정에서 실시간 소통으로 어떻게 확장되고 있는지를 극명하게 보여준다.
구글은 2025년 Google I/O에서 Google Meet에 **실시간 음성 번역(Speech Translation)**을 전격 도입했다. 이 기능은 단순히 외국어 자막을 띄우는 수준이 아니다. 회의 참가자가 모국어로 말하면, 상대방에게는 번역된 언어의 음성이 실시간으로 합성되어 들린다. 이때 들리는 목소리는 화자 고유의 톤과 말투, 말의 빠르기를 그대로 복제한 AI 음성이며, 배경에는 원래 화자의 육성이 은은하게 깔려 어색함을 지운다.
그 진화 속도는 경이롭다.
- 2026년 초 출시 당시에는 영어와 유럽 주요 언어(스페인어·프랑스어·독일어·포르투갈어·이탈리아어) 간의 일대일 번역만 지원했고, 화자마다 2~3초가량의 처리 지연이 있었다.
- 2026년 4월, 구글은 말이 끝나기를 기다리지 않고 스트리밍 방식으로 음성을 즉시 변환하는 다국어 실시간 음성 번역 기능을 모바일 환경으로 확대 적용했다([Google Workspace Updates](https://workspaceupdates.googleblog.com/2026/04/speech-translation-in-google-meet-is-now-rolling-out-to-mobile-devices.html)).
- 그리고 2026년 10월 22일, Gemini 3.5 Live Translate 기반의 실시간 음성 통역 지원 범위를 웹과 모바일에서 **한국어를 포함한 63개 언어로 확대**했다([Google Workspace Updates](https://workspaceupdates.googleblog.com/2026/10/real-time-speech-translation-in-google-Meet-expands-to-63-languages-with-automatic-language-detection.html)). 이제 Meet는 회의 중에 누가 어떤 언어로 말하든 언어를 자동으로 감지해 청취자가 설정한 언어로 지체 없이 통역을 내보낸다. 여러 언어가 뒤섞여 대화가 오가도 회의는 중단 없이 이어진다.
영상 플랫폼인 유튜브에서도 동일한 변화가 일어났다. 유튜브는 크리에이터들을 위한 **AI 자동 더빙(Auto-dubbing)** 지원 언어를 27개로 확대했으며, 하루 평균 수백만 명 이상의 시청자가 AI 더빙으로 변환된 영상을 시청한다. 화자의 감정과 에너지를 그대로 살려내는 표현력 있는 음성(Expressive Speech) 기술이 결합되었고, 번역된 음성의 입술 모양에 맞춰 영상 속 입 모양을 미세하게 재합성하는 **AI 립싱크(Lip-sync) 기능** 역시 일부 크리에이터들을 대상으로 시범 운영되고 있다([YouTube Official Blog](https://blog.youtube/)).
기계가 넘은 기술적 문턱이 ‘무엇을 말했는가(내용)’에서 ‘어떻게 말했는가(어조, 뉘앙스, 표정과 몸짓)’로 확장된 것이다. 활자 번역가를 넘어 동시통역사, 성우, 더빙 스튜디오의 고유 영역까지 기술의 영역권 안으로 들어서고 있다.
### 3.3 반론: 기계가 아직 건너지 못하는 영역
그렇다면 인간 번역이라는 행위 자체가 완전히 소멸할 것인가? 그렇게 단정하기는 어렵다. 기계가 결코 건너지 못하는 세 가지 확고한 영역이 존재하기 때문이다.
- **문학 번역과 텍스트의 미학**: 문학 번역은 단순한 정보의 등가 치환이 아니다. 언어의 고유한 리듬과 어조, 원작자의 침묵과 파열음, 시대적 결을 다른 언어의 토양 위에 완전히 새롭게 짓는 재창작이다. 기계가 아무리 유려한 문장을 흉내 낸다 한들, 어떤 문체를 선택하고 어떤 단어의 어감으로 독자에게 말을 건넬지 결단하는 것은 인간 번역가의 고유한 문학적 해석의 영역이다.
- **법적·윤리적 책임이 따르는 번역**: 국가 간 조약문, 다국적 기업의 인수합병 계약서, 형사 재판 판결문, 임상시험 의약품 설명서 등에서 오역은 수천억 원의 손해배상이나 인간의 생사로 직결된다. 기계는 번역을 수행할 수는 있지만, 그 결과에 대해 사회적·법적 책임을 질 주체가 될 수 없다.
- **문화의 결(Contextual Texture)**: 한국어의 미묘한 높임법 체계나 '정(情)', '눈치', '서운함' 같은 단어는 단어 대 단어의 매핑으로 환원되지 않는다. 화자와 청자의 사회적 관계, 대화의 역사, 행간의 침묵을 읽어내는 직관이 필요하다. 벤더가 지적한 '형식'과 '의미'의 간극이 가장 날카롭게 드러나는 지점이다.
### 3.4 번역가의 역할이 옮겨 간다
결국 번역은 사라지는 것이 아니라 무게중심이 이동하고 있다. 활자를 기계적으로 바꾸고 음성을 변환하는 실무는 기계의 몫이 되겠지만, **무엇을 어떤 맥락으로 옮길지 판단하고 최종 결과물에 윤리적·사회적 책임을 지는 일**은 인간 번역가에게 남는다. 다리를 직접 놓던 기술자에서, 다리의 안전성과 진실성을 검증하는 보증인으로 역할이 바뀌는 셈이다.
하지만 이 변화는 더 근본적인 철학적 물음으로 이어진다. Google Meet의 다국어 회의실에서 각국 참가자들은 공통어를 사용하지 않는다. 한국인은 한국어로 말하고, 프랑스인은 프랑스어로 들으며, 브라질인은 포르투갈어로 말한다. 회의실 안에 단 하나의 공통어도 존재하지 않는데 소통은 완벽하게 성립한다. 그렇다면 인류에게 ‘공통의 언어’는 앞으로도 여전히 필요할까?
## 4. 인류는 늘 공통어를 찾아왔다
### 4.1 힘으로 퍼진 공통어
인류는 수천 개의 언어로 쪼개져 살았지만, 서로 다른 집단이 만나 교역하고 통치할 때마다 늘 **공통어(링구아 프랑카, Lingua Franca)**를 찾아냈다. ‘링구아 프랑카’라는 이름 자체가 중세 지중해 연안에서 무역상과 선원들이 의사소통을 위해 사용하던 혼성 교역어에서 유래했다.
- 지중해 세계의 **코이네 그리스어**와 **라틴어**는 로마 제국의 행정과 학문, 교회의 질서를 통일했다.
- 이슬람 제국의 팽창과 함께 **아랍어**는 중동과 북아프리카를 아우르는 종교와 학술의 표준어가 되었다.
- 동아시아의 **한문(漢文)**은 우리에게 가장 친숙한 공통어의 사례다. 조선, 중국, 일본, 베트남의 지식인들은 입말(음성언어)로는 서로 한마디도 통하지 않았지만, 종이 위에 붓으로 한자를 쓰는 **필담(筆談)**을 통해 심오한 외교적·철학적 대화를 막힘없이 나눌 수 있었다. 입으로 읽는 발음은 각 나라마다 천차만별이었지만 글자가 가리키는 의미의 핵은 같았기 때문이다. *“소리는 달라도 의미는 공유되는 표의 문자 체계”*, 이 특성은 이 글의 후반부에서 대단히 중요한 복선이 된다.
- 그리고 오늘날의 **영어**는 항공, 해운, 인터넷, 외교, 학술 연구의 독점적 공통어로 군림하고 있다.
이 역사적 공통어들은 언어 구조가 다른 언어보다 우월해서 널리 쓰인 것이 결코 아니다. 군사적 정복, 종교적 권위, 무역망의 장악, 그리고 과학기술의 패권이라는 '힘'에 의해 확산된 것이다. 언어학자 막스 바인라이히(Max Weinreich)가 청중의 말을 인용해 남긴 명언, **“언어란 육군과 해군을 가진 방언이다(אַ שפּראַך איז אַ דיאַלעקט מיט אַן אַרמיי און פֿלאָט)”**라는 말처럼, 공통어는 언제나 누군가 강자의 모국어였다. 그 언어를 모국어로 타고난 자는 막대한 기득권을 누렸고, 비모국어 화자는 평생에 걸쳐 언어적 불평등과 학습의 비용을 감당해야 했다.
### 4.2 이미 작동하는 공통어: STEM의 두 겹
이러한 힘의 논리가 가장 분명하게 관철되면서도 동시에 가장 기묘한 방식으로 탈피하는 영역이 바로 과학·기술·공학·수학(STEM) 분야다. STEM 생태계에는 이미 두 겹의 공통어가 병존하고 있다.
첫 번째 겹은 자연어로서의 **영어**다. 20세기 초까지만 해도 과학의 중심 언어는 독일어와 프랑스어였으나, 두 차례의 세계대전과 미국의 패권을 거치며 현대의 모든 첨단 학술 논문은 영어로 출판된다. 이는 세계의 연구자들을 하나로 묶는 편리한 도구이지만, 비영어권 연구자들에게는 연구 성과와 별개로 막대한 언어적 장벽을 강요하는 불평등한 공통어다.
두 번째 겹은 그 어떤 국가나 민족의 말도 아닌, **순수한 형식 언어(Formal Language)**다.
- **수학 기호**: 적분 기호(∫), 총합 기호(Σ), 전칭 기호(∀), 등호(=)는 한국의 수학자나 브라질의 공학자나 똑같은 의미로 해석한다. 음성적 발음은 제각각이지만 의미적 구조는 완전히 일치한다.
- **화학식과 IUPAC 명명법**: 물 분자를 가리키는 `H₂O`는 한국어로 '물'이라 부르든, 영어로 'water'라 부르든, 스페인어로 'agua'라 부르든 전 세계 연구실에서 오직 동일한 화학적 실체를 지칭한다.
- **국제단위계(SI)**: 미터(m), 킬로그램(kg), 초(s)는 국경과 문화를 초월해 동일한 물리량을 엄격하게 정의한다.
- **프로그래밍 언어**: 파이썬, C, 러스트로 작성된 소스코드는 서울에서 실행하든 베를린에서 실행하든 완전히 동일한 논리적 명령을 수행한다. 인간이 고안해 대중화시킨 최초의 완벽한 기계적 공통어다.
이 형식 언어들은 과거 동아시아 지식인들이 한문 필담을 나누던 원리와 본질적으로 같다. 발음은 다르지만 의미는 완전히 통한다. 결정적인 차이는 '엄밀성'에 있다. 한문은 맥락에 따라 다양한 해석의 여지가 열려 있었지만, 수학과 코드는 단 하나의 모호성도 허용하지 않도록 치밀하게 설계되었다. 1장에서 언급했던 라이프니츠의 꿈이 여기서 다시 나타난다. 인간의 생각을 엄밀한 기호로 계산하겠다는 그의 보편 기호법은 일상 언어에서는 좌절되었지만, 현대 기호논리학과 수학, 컴퓨터 프로그래밍 언어를 통해 STEM의 영토 안에서 화려하게 부활했다. 라이프니츠가 손수 고안한 미분 기호(`dx`, `∫`)가 수백 년이 지난 지금도 전 세계 수학교과서에 그대로 쓰이고 있다는 사실은 상징적이다.
### 4.3 설계된 공통어: 철학적 언어에서 에스페란토까지
STEM이 증명한 교훈은 명확했다. 의미의 범위를 한정하고 고도의 논리적 정밀성을 요구하는 영역에서는 인간이 의도적으로 설계한 공통어가 실제로 성공할 수 있다는 점이다. 그렇다면 인간의 삶 전체, 감정과 사유 전체를 아우르는 보편 공통어도 인간의 지성으로 설계할 수 있지 않을까? 인류 지성사에는 이 거대한 도전에 평생을 바친 이들이 있었다.
- **17세기 철학적 언어**: 존 윌킨스(John Wilkins, 1668) 같은 학자들은 인간이 경험하는 삼라만상의 모든 개념을 방대한 분류 체계로 정리하고 각 범주에 논리적 기호를 부여한 인공어를 시도했다. 단어의 글자 형태만 보아도 그것이 동물인지 식물인지, 어떤 속성을 지녔는지 연역할 수 있게 하려는 구상이었다. 너무 비대하고 복잡해 실용화에는 실패했지만, 개념의 다차원 좌표를 먼저 세우고 언어를 배치한다는 발상은 훗날 AI의 벡터 공간을 놀랍도록 닮아 있었다.
- **볼라퓌크(Volapük, 1879)**: 독일의 요한 마틴 슐라이어(Johann Martin Schleyer) 신부가 고안한 인공어로, 전 세계 수십만 명의 회원을 모으며 선풍적인 인기를 끌었으나 극도로 복잡한 문법 규칙과 창안자의 독단적인 운영으로 급격히 쇠락했다.
- **에스페란토(Esperanto, 1887)**: 폴란드의 유대계 안과의사 루도비코 라자로 자멘호프(L. L. Zamenhof)가 창안했다. 폴란드인, 러시아인, 독일인, 유대인이 뒤섞여 서로의 말을 이해하지 못하고 증오를 키워가던 고향 비아위스토크의 비극을 목격한 그는, 언어의 장벽이야말로 편견과 전쟁의 뿌리라고 믿었다. 그는 극도로 배우기 쉬운 규칙적 인공어를 설계했다. 모든 명사는 `-o`, 형용사는 `-a`, 부사는 `-e`로 끝나며 예외 문법이 전혀 없다. 기본 단어에 반대를 뜻하는 접두사 `mal-`을 붙이면 새로운 단어가 논리적으로 파생된다(`bona`=좋은, `malbona`=나쁜). 에스페란토는 인류 역사상 가장 성공한 인공어로 자리 잡아 오늘날에도 수십만에서 최대 200만 명 수준으로 추산되는 사용자와 고유한 문학 작품을 보유하고 있다.
### 4.4 에스페란토는 왜 세계어가 되지 못했나
에스페란토의 숭고한 이상에도 불구하고, 그것이 영어를 제치고 인류의 보편 세계어가 되지 못한 이유는 뼈아픈 세 가지 현실적 한계 때문이었다.
- **태생적 유럽 편향**: 에스페란토의 어휘와 문법은 로망스어, 게르만어, 슬라브어 등 유럽 인도유럽어족의 유산에서 90% 이상 차용되었다. 유럽인에게는 몇 주 만에 배울 수 있는 쉬운 언어였을지 몰라도, 한국어·중국어·아랍어·스와힐리어 화자에게는 그저 또 하나의 낯설고 이질적인 유럽어에 불과했다.
- **네트워크 효과(Network Effect)의 장벽**: 언어의 가치는 그 언어를 구사하는 사람의 수에 정비례해 기하급수적으로 폭증한다. 영어를 배우면 전 세계 수억 명의 사람들과 사업을 하고 문화를 나눌 수 있지만, 에스페란토를 배울 유인은 지극히 작았다. 닭이 먼저냐 달걀이 먼저냐의 함정에 빠진 것이다.
- **물리적 힘과 국가 권력의 부재**: 바인라이히의 말처럼 에스페란토에는 군대도, 거대한 내수 시장도, 그것을 국어로 채택한 주권 국가도 없었다. 오히려 히틀러의 나치 정권과 스탈린의 소련 정권은 에스페란토 사용자들을 ‘국제주의 스파이’나 ‘불온분자’로 몰아 가혹하게 탄압했다.
에스페란토의 한계와 STEM 형식 언어의 성공을 나란히 놓으면 결정적인 통찰을 얻게 된다. 설계의 아름다움만으로는 언어가 널리 퍼질 수 없다. 진정한 공통어가 되려면 **‘누구의 소유도 아니어서 모두에게 공평해야 하며(중립성)’, ‘모두가 반드시 써야만 하는 압도적인 실용적 유인(필연성)’**을 갖추어야 한다.
### 4.5 AI 번역: 공통어는 사라지는가, 숨는가
이제 3장의 질문으로 다시 돌아가 보자. 모든 인류가 자기 모국어로 이야기하고 실시간 AI가 이를 지체 없이 상대방의 모국어로 바꾸어 전달해 준다면, 인류는 더 이상 다른 외국어나 인공 공통어를 배울 필요가 없어진다. 바벨탑을 다시 쌓아 하늘로 올라가는 대신, 흩어진 탑과 탑 사이를 기계의 거대한 네트워크 다리로 연결하는 현실이 눈앞에 다가왔다.
그렇다면 인류의 공통어는 이제 영원히 사라지는 것일까? 아니다. **공통어는 사라진 것이 아니라 기계의 내부로 숨어든 것이다.** 인간은 더 이상 공통어를 의식적으로 학습하지 않지만, 인간이 주고받는 모든 대화와 텍스트는 인간 그 누구도 육안으로 해독할 수 없는 기계 내부의 공통 좌표 공간을 반드시 통과한다. 그 숨겨진 공간의 정체가 바로 **초언어(Interlingua)**다.
## 5. 기계 안의 공통어: 초언어
### 5.1 제로샷 번역이 남긴 단서
앞서 언급했던 2016년 구글의 제로샷 번역 연구를 다시 떠올려보자. 연구진은 모델이 한 번도 병렬로 학습한 적 없는 일본어와 한국어 사이를 직접 번역해 냈을 때, 모델의 고차원 벡터 활성화 공간을 t-SNE 기법으로 시각화했다. 결과는 충격적이었다. 영어, 일본어, 한국어로 각각 적힌 문장들이지만, 그 문장들이 뜻하는 바가 같으면 언어의 외형적 차이와 상관없이 벡터 공간 속의 거의 동일한 좌표 지점에 옹기종기 뭉쳐 있었다.
연구진은 조심스럽게 가설을 세웠다. 다국어 모델이 번역을 수행할 때 언어 쌍마다 개별적인 변환 공식을 만드는 것이 아니라, **모든 언어를 아우르는 보편적인 의미의 공통 표현 층, 즉 일종의 ‘중간 언어(Interlingua)’를 모델 스스로 형성했을 가능성**을 제시한 것이다.
이 글에서는 이 공간을 기계번역의 오랜 이상인 **‘중간언어(Interlingua)’**라는 개념으로 다룬다. 중간언어는 *“어떤 특정한 개별 언어에도 속하지 않으면서 모든 인간 언어가 공유하는 개념적 의미의 심층 토대”*를 가리킨다. 한문이 ‘음성 없이 문자만 공유하는 언어’였다면, 신경망 내부의 중간언어는 **‘소리도 문자도 없이 다차원 연속 공간 속의 기하학적 형상으로만 존재하는 의미의 언어’**다. Google Meet가 한 회의 안에서 63개 언어를 실시간으로 뒤섞어 통역할 수 있는 기술적 비결 역시, 수천 개의 언어 쌍마다 번역기를 따로 만든 것이 아니라 이 단 하나의 공통 의미 지반을 경유하는 구조일 가능성이 높다.
### 5.2 발견된 지도: 플라톤적 표현 가설
과거 라이프니츠와 존 윌킨스는 이 개념의 지도를 인간의 머리로 직접 제도하려 했다. 언어학자 안나 비에르츠비카(Anna Wierzbicka)는 평생에 걸쳐 전 세계 모든 언어에 공통으로 존재하는 수십 개의 원초적 의미 원소('나', '너', '좋다', '알다', '원하다' 등)를 귀납적으로 채굴하려 했다. 하지만 AI는 지도를 책상머리에서 설계하지 않는다. 전 세계 인류가 남긴 방대한 데이터로부터 지도를 **‘스스로 발견(Discovery)’**한다.
2024년 MIT 등의 연구진이 제안한 **플라톤적 표현 가설(The Platonic Representation Hypothesis)**은 여기서 한 걸음 더 나아간다([Huh et al., 2024](https://doi.org/10.48550/arXiv.2405.07987)). 서로 완전히 다른 신경망 구조와 알고리즘으로 훈련된 모델이라 할지라도, 파라미터 규모와 데이터가 충분히 커지면 결국 **‘현실 세계의 통계적·물리적 구조를 반영하는 하나의 공통된 이상적 표현 공간으로 수렴(Convergence)’**한다는 주장이다. 최근 서로 다른 두 텍스트 임베딩 모델 사이에서 사전 짝지어진 병렬 데이터 없이도 임베딩 공간의 기하학적 보편성을 이용해 상호 정렬과 변환이 가능함을 증명한 연구([Jha et al., 2025](https://doi.org/10.48550/arXiv.2505.12540))는, 언어 모델들이 공통의 기하학적 구조를 공유한다는 가설에 중요한 실증적 단서를 제공했다(단, 텍스트 외 다른 모달리티로의 확장은 CLIP을 통한 예비적 관찰 단계다).
이 가설이 사실이라면, 인류가 쓰는 수천 개의 언어는 결코 단절된 섬들이 아니다. 그것은 **‘인간이 공유하는 현실이라는 동일한 대륙을, 각 문화권의 역사와 환경에 따라 서로 다른 글자와 발음으로 스케치해 온 수천 장의 지도’**에 불과하다. 그리고 AI는 방대한 데이터의 교차점을 통해 처음으로 그 지도들 아래에 깔려 있던 대륙의 진짜 형상을 어렴풋이 드러내 보여주고 있는 셈이다. 바벨탑 아래에는 처음부터 단 하나의 거대한 지도가 깔려 있었다.
### 5.3 말로 하지 않는 생각과 인간 너머의 소통
중간언어의 가능성은 인간 언어의 공통분모를 추출하는 데서 멈추지 않는다. 메타(Meta) FAIR 연구진이 발표한 코코넛(Coconut, Chain of Continuous Thought) 연구는 모델이 복잡한 논리적 추론을 수행할 때 인간의 언어(토큰)로 일일이 적지 않고, **연속적인 잠재 공간(Latent Space) 자체에서 직접 사유하는 방식**을 실험했다([Hao et al., 2024](https://doi.org/10.48550/arXiv.2412.06769)). 단어라는 이산적 병목을 거치지 않고 다차원 벡터 상태를 직접 다음 입력으로 순환시킴으로써, 특정 수학·논리 추론 과제에서 텍스트 기반 CoT보다 높은 탐색 유연성과 효율성을 입증했다.
루트비히 비트겐슈타인(Ludwig Wittgenstein)은 *“내 언어의 한계는 내 세계의 한계를 의미한다”*고 갈파했다. 그렇다면 인간의 언어라는 협소한 필터를 거치지 않고 순수한 고차원 기하학적 공간에서 생각하는 기계는, 과연 인간의 언어로 번역 불가능한 미지의 개념까지 탐색할 수 있을까?
이 질문은 인간 너머의 생명체로도 뻗어나간다. 향유고래의 음향 신호를 분석하는 프로젝트 CETI(Project CETI)나 지구상의 수많은 동물의 소통 체계를 해독하려는 ‘지구 생물종 프로젝트(Earth Species Project)’는 모두 대규모 언어모델의 벡터 임베딩 기술을 동물들의 소통에 적용하고 있다. 만약 이들이 성공한다면, 기계가 발견한 초언어 공간은 인간 언어 사이의 다리를 넘어 종(Species)과 종 사이를 연결하는 생태학적 번역 공간으로까지 팽창할 것이다.
## 6. 초언어 기반 인공어: 다음 세대의 공통어
과거의 에스페란토가 한 개인의 이상과 직관으로 설계한 인공어였다면, 인류가 마주할 다음 세대의 공통어는 기계가 발견해 낸 초언어의 다차원 기하학 구조에서 추출된 인공어일 수 있다. 이 새로운 공통어는 세 가지 진화 경로를 가질 수 있다.
- **인간을 위한 보편 인공어 (21세기의 네오-에스페란토)**: 전 세계 언어의 임베딩 공간을 다차원 통계적으로 분석해, 모든 문화권의 언어로부터 기하학적 거리가 가장 고르게 분배된 진정한 중립적 어휘와 문법을 도출하는 방식이다. 에스페란토의 치명적 약점이었던 유럽 편향을 수학적으로 극복할 수 있다. 그러나 이 언어의 최대 라이벌은 영어가 아니라 '너무나 완벽하게 작동하는 실시간 번역기'일 것이다. 번역기가 모든 말을 귀에 꽂아주는 시대에 사람이 굳이 새 언어를 배울 유인은 지극히 낮다.
- **인간과 기계 사이의 협업 인터페이스 언어 (STEM 혼합 언어)**: 훨씬 더 현실적인 경로는 자연어와 수학, 소스코드, 린(Lean) 같은 기계 검증 형식 증명 언어가 하나로 결합된 하이브리드 언어다. 사람은 자기 모국어로 개념을 설명하고, 인공지능은 그 논리 구조를 초언어 공간의 엄밀한 형식 기호로 번역해 검증한다. 소리는 달라도 뜻이 모호하지 않은 한문 필담의 원리와 수식의 엄밀성이 AI 협업이라는 실용적 도구로 되살아나는 것이다. 라이프니츠의 꿈이 세 번째로 모습을 바꾼 순간이다.
- **기계만을 위한 내부 공통어 (인간이 배제된 언어)**: 인공지능 에이전트들이 서로 대화할 때 인간의 언어는 지나치게 길고 비효율적인 압축 손실을 초래한다. 에이전트들끼리 정보를 주고받을 때는 수만 개의 단어로 풀었다가 다시 벡터로 인코딩할 이유가 없다. 초언어 공간의 고차원 벡터 좌표를 네트워크 패킷으로 직접 송수신하는 것이 압도적으로 효율적이다. 이 언어는 인간이 화자가 아닌, 사상 최초의 ‘기계 전용 링구아 프랑카’가 될 것이다.
인류가 걸어온 공통어의 진화 과정을 한눈에 정리하면 다음과 같다.
| 단계 | 공통어 형태 | 성립 기반 | 누구의 언어인가 |
| --- | --- | --- | --- |
| 1단계 | 라틴어, 한문, 영어 | 제국, 종교, 군사력, 자본의 패권 | 강자의 언어 (배타적 기득권) |
| 2단계 | 에스페란토 | 인간의 머리로 설계한 보편 규칙 | 누구의 것도 아니지만 사실상 유럽의 언어 |
| 2′단계 | 수학 기호, 화학식, SI 단위계, 코드 | 고도의 정밀함을 요구하는 엄밀한 의미 영역 | 모두의 언어 (실제로 작동 중인 공통어) |
| 3단계 | AI 실시간 번역·음성 더빙 | 기계 내부의 공통 의미 벡터 공간 | 아무도 직접 읽을 수 없는 기계의 언어 |
| 4단계 | 초언어 기반 인공어 | 기계가 발견한 현실 세계의 의미 구조 | 인류 전체의 도구일 수도, 기계만의 것일 수도 |
이 표의 마지막 행이야말로 이 글이 묻고자 하는 궁극의 질문이다. 언어와 언어 사이의 그 거대한 공간은 과연 누구의 것인가? 그리고 그 공간은 온전히 축복이기만 한 것일까.
## 7. 초언어의 그림자
### 7.1 우리가 읽을 수 없는 언어 (사고의 블랙박스)
현재 인공지능 안전(AI Safety) 연구의 가장 중요한 안전장치는 모델이 문제 해결 과정을 인간의 자연어로 출력하게 하는 '생각의 사슬(Chain-of-Thought)'을 인간이 눈으로 감시하고 검증하는 일이다. 만약 인공지능들이 효율성을 이유로 인간이 읽을 수 없는 고차원 잠재 공간(Latent Space)에서 자기들만의 기호 체계로 생각하고 통신하기 시작한다면, 인간은 기계의 결정 과정을 통제할 수 없는 완벽한 암흑 속 관찰자로 전락하게 된다. **효율성과 투명성 사이의 치명적인 긴장**은 초언어 시대의 가장 첨예한 윤리적 쟁점이 될 것이다.
### 7.2 누구의 목소리인가 (정체성과 신뢰의 문제)
실시간 음성 번역과 더빙 기술은 자아의 정체성에 깊은 혼란을 불러일으킨다. 기계가 내 목소리와 어조를 정교하게 흉내 내어 내가 한 번도 배운 적 없는 스와힐리어나 아랍어로 말할 때, 그 발화의 진정한 주체는 누구인가? 기계가 문맥을 오해해 원래의 의도와 미묘하게 어긋난 문장을 합성해 내더라도, 듣는 상대방은 그것을 나의 진심 어린 목소리로 받아들이게 된다. 유튜브가 AI 더빙 콘텐츠에 SynthID 기반의 보이지 않는 디지털 워터마크를 심고, 구글 Meet가 음성 번역을 사용자가 직접 제어하며 모델 학습에 음성을 무단 사용하지 않겠다고 밝힌 것은 바로 이 '신뢰의 위기'를 방어하기 위한 조치다.
### 7.3 다시 나타나는 강자의 언어 (데이터 편향)
실제로 다국어 트랜스포머 모델의 중간 계층을 분석한 연구([Wendler et al., 2024](https://doi.org/10.18653/v1/2024.acl-long.820))에 따르면, 모델 내부의 잠재 표현 공간은 다른 언어보다 영어가 가진 통사적·개념적 특성에 유의미하게 편향되어 있다는 사실이 확인된다. 인터넷 텍스트 데이터의 압도적 다수가 영어로 작성되었기 때문이다. 기계 내부의 공통 지도가 가장 많은 데이터를 가진 언어 쪽으로 심하게 기울어져 있다면, 중간언어는 중립적인 대륙이 아니라 **특정 패권 언어의 세계관과 가치관을 전 지구에 무의식적으로 이식하는 보이지 않는 식민화의 통로**가 될 수 있다. 과거 라틴어와 영어가 행사했던 힘의 논리가 ‘데이터 자본’이라는 새로운 가면을 쓰고 되돌아오는 셈이다.
현재 지구상에는 약 7,000여 개의 언어가 존재하지만, 인공지능이 유의미하게 학습할 수 있는 디지털 텍스트를 남긴 언어는 극소수다. 한국어처럼 비교적 데이터가 풍부한 언어조차 고유한 높임법과 정서적 뉘앙스가 서구적 합리성의 문법 속에서 매끄럽게 탈색될 위험에 처해 있다. 데이터가 빈약한 소수 언어들은 기계가 그리는 지도 위에 이름조차 올리지 못한 채 영원히 지도 밖으로 지워질 수도 있다.
### 7.4 지도인가, 그림자인가
마지막으로 던져야 할 근본적인 회의가 있다. 에밀리 벤더의 통찰처럼, 기계가 발견해 낸 그 유려한 벡터 공간은 현실 세계의 참된 본질(대륙)이 아니라, 그저 **인간이 인터넷에 쏟아낸 방대한 글자들이 드리운 통계적 그림자들의 집합**일지도 모른다. 그림자들이 기하학적으로 정교하게 배열되어 있다고 해서 그것이 곧 현실의 땅 그 자체를 의미하지는 않는다. 만약 우리가 발견했다고 믿는 초언어가 실은 디지털 세계의 편향된 텍스트 잔해들을 그럴듯하게 비추어낸 환영에 불과하다면, 그것은 세계의 본질을 비추는 지도가 아니라 인터넷이라는 거울의 굴곡진 표면을 닮게 될 것이다.
## 맺으며: 바벨탑 아래의 지도, 그리고 다리 위의 사람들
이 글은 번역가의 고요한 책상에서 시작했다. 기계가 먼저 토해낸 문장을 조심스럽게 다듬는 번역가, 그리고 같은 기계를 살아있는 언어의 표본으로 삼아 들여다보는 언어학자가 그 자리에 있었다. 그들의 상반된 시선은 결국 동일한 물음에서 갈라져 나왔다. 언어와 언어 사이를 건너는 그 공간의 정체는 무엇이며, 그것은 누구의 것인가.
인류 역사에서 그 공간에 놓였던 다리는 늘 모습을 바꾸어 왔다. 라틴어와 한문, 영어는 힘과 권력으로 놓은 다리였다. 에스페란토는 인간의 순수한 이상으로 설계했으나 끝내 대중이 건너지 않은 다리였다. 수학과 코드는 좁지만 견고하여 지금도 전 세계의 지식인들이 매일같이 건너는 다리다. 그리고 오늘날 구글 Meet의 다국어 회의실과 유튜브의 자동 더빙 화면은, 모든 사람이 각자의 모국어로 이야기하면서도 서로에게 가닿는 완전히 새로운 종류의 다리를 보여주고 있다. 그 다리는 기계 내부의 거대한 공통 의미 공간, 곧 **초언어(Interlingua)**라는 신비로운 지반 위에 닻을 내리고 있다.
17세기 라이프니츠의 꿈은 세 번 형태를 바꾸었다. 규칙의 시대에는 실패했고, STEM의 영토에서는 수식과 코드로 실현되었으며, 이제는 기계 안에서 스스로 드러난 다차원 지도로 되살아났다. 그러나 부활한 세 번째 꿈 앞에는 과거에 없던 무거운 질문들이 놓여 있다. 그 지도를 과연 인간이 끝까지 읽어낼 수 있는가? 그 지도에는 얼마나 다양한 인간의 목소리가 온전히 새겨져 있는가? 그 지도는 특정 강자의 편향된 시선으로 왜곡되어 있지 않은가?
루도비코 자멘호프는 에스페란토가 각 민족의 고유한 모국어를 파괴하거나 대체하기를 결코 원하지 않았다. 그는 에스페란토가 모국어라는 고유한 집을 지키면서도 타인을 만나러 갈 때 함께 입는 '공통의 외투'가 되기를 바랐다. 기계가 발견해 낸 초언어에도 동일한 윤리가 요구된다. 초언어는 수천 개의 인간 언어를 하나의 획일적인 기계 부호로 용해시키는 거대한 용광로가 되어서는 안 된다. 수천 개의 언어가 각자의 색채와 결을 잃지 않은 채 서로를 온전히 투영하는 다채로운 거울들의 방이 되어야 한다.
그렇다면 기계가 다리를 도맡아 놓는 시대, 번역가의 진짜 자리는 어디에 있는가? 번역가는 다리를 놓는 기술자에서, 그 다리가 인간의 존엄성과 진실을 배반하지 않는지 감시하는 **수호자이자 증인**이 된다. 기계가 뱉어낸 번역이 원작자의 영혼과 침묵을 배반하지 않았는지 끝끝내 지켜보고, 통계적 지도의 바깥으로 밀려나 지워질 위기에 처한 소수 언어의 여린 숨결과 문화적 맥락을 기억하는 사람이다. 바벨탑 아래 묻혀 있던 태초의 지도를 기계가 마침내 드러내 보여주고 있는 오늘, 그 지도를 올바르게 읽고, 비판적으로 고치며, 더 넓고 따뜻하게 확장해 나가는 마지막 책임은 여전히 우리 인간의 손에 쥐어져 있다.
## 참고문헌 (References)
- Bender, E. M., & Koller, A. (2020). Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data. In *Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics* (pp. 5185–5198). DOI: [10.18653/v1/2020.acl-main.463](https://doi.org/10.18653/v1/2020.acl-main.463)
- Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? 🦜. In *Proceedings of the 2021 ACM FAccT Conference* (pp. 610–623). DOI: [10.1145/3442188.3445922](https://doi.org/10.1145/3442188.3445922)
- Dumas, C., Monea, G., Veselovsky, V., Wendler, C., & West, R. (2025). The Geometry of Multilingual Representations. In *Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (ACL 2025)*.
- Hao, S., Sukhbaatar, S., Su, D., Li, X., Hu, Z., Weston, J., & Tian, Y. (2024). Training Large Language Models to Reason in a Continuous Latent Space. *arXiv preprint arXiv:2412.06769*. DOI: [10.48550/arXiv.2412.06769](https://doi.org/10.48550/arXiv.2412.06769)
- Hewitt, J., & Manning, C. D. (2019). A Structural Probe for Finding Syntax in Word Representations. In *Proceedings of the 2019 Conference of the NAACL* (pp. 4129–4138). DOI: [10.18653/v1/N19-1419](https://doi.org/10.18653/v1/N19-1419)
- Huh, M., Cheung, B., Wang, T., & Isola, P. (2024). The Platonic Representation Hypothesis. In *Forty-first International Conference on Machine Learning (ICML 2024)*. DOI: [10.48550/arXiv.2405.07987](https://doi.org/10.48550/arXiv.2405.07987)
- Jha, N., Zhang, L., Shmatikov, V., & Morris, J. X. (2025). Harnessing the Universal Geometry of Embeddings. *arXiv preprint arXiv:2505.12540*. DOI: [10.48550/arXiv.2505.12540](https://doi.org/10.48550/arXiv.2505.12540)
- Johnson, M., Schuster, M., Le, Q. V., Krikun, M., Wu, Y., Chen, Z., ... & Dean, J. (2017). Google’s Multilingual Neural Machine Translation System: Enabling Zero-Shot Translation. *Transactions of the Association for Computational Linguistics*, 5, 339–351. DOI: [10.1162/tacl_a_00065](https://doi.org/10.1162/tacl_a_00065)
- Piantadosi, S. T. (2024). Modern language models refute Chomsky's approach to language. In E. Gibson & M. Poliak (Eds.), *From fieldwork to formal grammar: Essays in honor of Dan Everett* (Chapter 15, pp. 353–414). Language Science Press. DOI: [10.5281/zenodo.12665933](https://doi.org/10.5281/zenodo.12665933)
- Pires, T., Schlinger, E., & Garrette, D. (2019). How multilingual is Multilingual BERT? In *Proceedings of the 57th Annual Meeting of the ACL* (pp. 4996–5001). DOI: [10.18653/v1/P19-1493](https://doi.org/10.18653/v1/P19-1493)
- Wendler, C., Veselovsky, V., Monea, G., & West, R. (2024). Do Llamas Work in English? On the Latent Language of Multilingual Transformers. In *Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers)* (pp. 15366–15394). ACL. DOI: [10.18653/v1/2024.acl-long.820](https://doi.org/10.18653/v1/2024.acl-long.820)
---
# 사람과 AI가 모두 읽기 좋은 블로그 만들기: AI 친화적 웹(llms.txt·WebMCP)과 DNSSEC 보안 개편 기록
*Published on 2026-10-29 by | Category: 연구 & 비평, 테크 & 코드*
**URL**: https://mixedlog.com/archives/2023
---
인간 독자에게는 종이책처럼 읽기 편한 화면을, AI 에이전트에게는 군더더기 없는 요약 지도(llms.txt)와 표준 API 카탈로그를 건네면서, 도메인과 서버의 보안 경계는 암호학적으로 단단히 잠근 블로그 개편 기록
## 1. 들어가며: 웹사이트의 방문자가 사람만이 아닌 시대
이전 글([「넷 안의 넷: AI 시대, 인터넷은 ‘이너넷’과 ‘아우터넷’으로 분열할까?」](https://mixedlog.com/archives/2016))에서 다루었듯, 오늘날 인터넷을 오가는 주체는 사람만이 아니다. 실제로 최근 2주 동안 `mixedlog.com`의 웹서버 방문 기록(Access Log)을 분석해 보니 꽤 흥미로운 숫자가 확인되었다. 구글(`Googlebot` 528회)이나 네이버(`Yeti` 49회) 같은 전통적인 검색엔진 크롤러뿐만 아니라, OpenAI의 `GPTBot`(565회), 앤트로픽의 `ClaudeBot`(572회), 퍼플렉시티의 `PerplexityBot`(429회), 애플의 `Applebot`(321회) 등 수많은 인공지능(AI) 에이전트들이 쉼 없이 블로그를 찾아오고 있었다.
사실 일반적인 PC 브라우저나 빠른 스마트폰 통신망으로 접속하는 사람 눈에는 기존 블로그도 아무런 문제 없이 깔끔하고 빠르게 잘 보였다. 하지만 시선을 조금 바꾸어 **‘AI 에이전트가 읽을 때의 효율성’**과 **‘검색엔진 성능 측정 도구가 채점하는 극한의 모바일 환경’**이라는 기준으로 내부를 들여다보자, 평소 눈으로는 보이지 않던 기술적 병목과 빈틈들이 드러났다.
- **AI 에이전트에게 비효율적이었던 점**: AI는 본문 텍스트와 문서 구조만 읽으면 되는데, 화면의 여백·색상·메뉴 배치를 담당하는 수천 줄의 HTML 태그와 스크립트까지 전부 읽느라 토큰(Token, AI가 글자를 처리하는 단위)을 낭비하고 있었다. 게다가 앞단의 보안 네트워크(Cloudflare)가 기본 정책에 따라 ChatGPT나 클로드 같은 정식 AI 봇의 접근까지 `403 Forbidden(접근 거부)`으로 가로막고 있었다.
- **내부 구조와 성능 측정 기준에서 아쉬웠던 점**: 일상적인 접속 환경에서는 쾌적했지만, 구글의 웹 성능 측정 도구(Lighthouse)가 해외나 음영 지역의 느린 통신망(Slow 4G)과 캐시 없는 첫 방문을 가정해 채점할 때는 2.1MB짜리 한글 통짜 웹폰트가 지표상 6.4초의 렌더링 지연을 기록하고 있었다. 또한 첫 화면(홈 피드) HTML 안에 긴 논문 전문이 모두 포함되어 있어, 화면에 보이는 것 이상으로 문서 용량(224KB)이 불필요하게 무거운 상태였다.
이번에 진행한 블로그 개편의 목표는 단순하고 명확했다. **“글을 읽으러 오는 사람과 AI 에이전트에게는 각각 가장 읽기 편한 전용 통로를 열어주되, 비밀번호나 서버 설정 파일을 노리는 악성 스캐너와 도메인 위변조 시도는 암호학적으로 철저히 차단한다.”** 비전공자도 흐름을 쉽게 따라올 수 있도록 비유를 곁들이되, 실제 적용한 웹 표준(RFC)과 기술적 작동 원리까지 하나씩 상세히 기록해 둔다.
## 2. 여러 AI에게 블로그 진단을 맡겼을 때 드러난 차이
개편 과정에서 흥미로운 실험을 하나 진행했다. 서로 다른 환경에서 작동하는 여러 AI에게 `mixedlog.com`의 기술적 상태를 점검해 달라고 요청한 것이다. 결과는 AI가 웹에 접근하는 기술적 방식에 따라 극명하게 갈렸다.
- **실시간 접속 없이 검색 색인만으로 추론해 오진한 경우**: 웹페이지를 직접 가져오지(Fetch) 못하는 한 웹챗 AI는 구글 검색 연산자(`site:mixedlog.com`)에 아직 페이지가 색인되지 않았다는 사실 하나만 보고 *“자바스크립트로만 화면을 그리는 빈 껍데기 구조(CSR SPA)여서 검색엔진이 본문을 읽지 못하는 상태”*라고 진단했다. 실제로는 워드프레스 서버가 완성된 HTML 본문을 내려주는 서버 사이드 렌더링(SSR) 구조였음에도, 직접 HTTP 응답을 확인하지 않고 흔한 장애 사례를 그대로 대입해 틀린 결론을 내린 것이다.
- **실제 헤드리스 브라우저(Headless Browser)로 접속해 런타임 오류까지 찾아낸 경우**: 반면 실제 크로미움(Chromium) 브라우저 엔진으로 접속한 감사 에이전트는 첫 화면을 구성하는 문서 객체 모델(DOM) 노드의 개수(379개), 본문 목차(TOC) 앵커 링크 21개가 실제 소제목(`id`)과 1:1로 매칭되는지, 이미지 `alt` 속성과 Open Graph 메타태그가 존재하는지까지 정확히 검증했다. 특히 일반 방문자 눈에는 보이지 않는 브라우저 개발자 도구 콘솔(Console) 로그에서 **WebMCP 검색 도구가 중복 이름으로 등록되며 `InvalidStateError: Failed to execute 'registerTool' on 'ModelContext': Duplicate tool name 'search_mixedlog'` 예외를 던지고 있다는 점**까지 정확히 짚어냈다.
이러한 교차 검증과 클로드(Claude)의 설정 파일 검토, 그리고 구글 Lighthouse 모바일 성능 측정 결과를 바탕으로 수정한 핵심 기술 내역은 다음과 같다.
| 점검 영역 | 개편 전 상태 (Before) | 개편 후 상태 (After) |
| --- | --- | --- |
| 첫 화면 구조와 무게 | 긴 글 전문이 그대로 노출되어 무거움 (224KB) | 첫 문단 자동 발췌 + 계속 읽기 → 구조로 전환 (105KB로 53% 감량) |
| 모바일 폰트 및 렌더링 | 2.1MB 통짜 폰트 다운로드로 첫 화면이 6.4초 지연 | 유니코드 분할 로드(30KB) + 비동기 스타일시트 적용으로 차단 지연 0ms 달성 |
| AI용 안내서 (llms.txt) | 카테고리 경로 불일치(404) 및 한글 인코딩 깨짐 | 실제 카테고리 주소 매핑 및 text/plain; charset=utf-8 헤더 명시 |
| AI용 합본 (llms-full.txt) | 이름만 전체 본문(Full)이고 실제로는 링크 30줄만 존재 | 주요 논문·비평 4편의 전문(3,000여 줄)이 담긴 96KB 마크다운 코퍼스 구축 |
| AI 출입 규칙 (robots.txt) | Cloudflare 403 차단 및 ai-train 신호 모순, RFC 9309 규칙 누락 | 정식 AI 봇 200 OK 개방 및 User-agent: * 단일 블록으로 보호 규칙 통합 |
| 도메인 위변조 방지 | 상위 레지스트리에 암호화 서명(DS 레코드) 미연결 | .com 레지스트리에 DNSSEC DS 레코드(Key Tag 2371) 등록 및 AD: true 검증 완료 |
## 3. AI 에이전트를 위한 전용 통로 설계 (AI-Native 웹 아키텍처)
최근에는 궁금한 주제가 생겼을 때 검색엔진 결과창을 일일이 클릭하는 대신 ChatGPT, 클로드, 퍼플렉시티 같은 AI에게 질문해 종합된 답변과 출처 링크를 얻는 경우가 많다. 이를 흔히 **GEO(Generative Engine Optimization, 생성형 엔진 최적화)** 또는 **에이전트 친화적 웹(Agent-Ready Web)**이라 부른다. 이번 개편에서는 AI 에이전트가 블로그에 도착한 순간부터 본문을 읽고 검색하기까지의 전 과정을 네 가지 웹 표준 기술로 설계했다.
**1단계 · 입구 안내도 및 카탈로그 탐색**HTTP Link 헤더, /llms.txt, /.well-known/api-catalog로 구조 파악
↓
**2단계 · 순수 마크다운 본문 또는 전문 합본 로드**Accept: text/markdown 콘텐츠 협상 또는 /llms-full.txt(96KB) 일괄 로드
↓
**3단계 · 내장 검색 도구(WebMCP) 및 REST API 실행**navigator.modelContext의 search_mixedlog_api로 키워드 직접 질의
### 3.1 HTTP 콘텐츠 협상(Content Negotiation)을 통한 마크다운 직접 반환
사람이 브라우저로 접속할 때는 종이 질감의 배경색, 여백, 글씨체, 상단 메뉴바가 갖춰진 웹페이지(HTML)가 필요하다. 하지만 글의 내용만 파악하려는 AI 에이전트에게 이러한 화면 꾸밈 코드(HTML 태그, CSS 클래스, 자바스크립트)는 불필요한 짐일 뿐이다. 식당에 비유하면 **매장을 찾은 손님에게는 그릇과 상차림을 갖춰 내어주고, 포장(배달) 주문에는 용기에 음식 알맹이만 깔끔하게 담아 주는 것**과 같다.
이를 웹 기술에서는 **HTTP 콘텐츠 협상(Content Negotiation, RFC 9110)**이라고 부른다. 같은 인터넷 주소(URL)에 접속하더라도 클라이언트가 요청 헤더(Request Header)에 `Accept: text/html`을 보내면 일반 웹페이지를 내려주고, AI 에이전트가 `Accept: text/markdown`을 담아 보내면 워드프레스의 `template_redirect` 단계에서 테마 렌더링을 건너뛰고 **메타데이터(제목·작성일·카테고리·원문 주소)와 순수 본문만 정제한 마크다운(Markdown) 문서로 즉시 변환해 응답**하도록 구현했다.
여기서 기술적으로 매우 중요한 세부 설정이 두 가지 더 들어간다.
- **캐시 오염을 막는 `Vary: Accept` 헤더**: 클라우드플레어(CDN)나 브라우저 캐시 서버는 기본적으로 ‘인터넷 주소(URL)’만 보고 응답 결과를 저장해 둔다. 만약 AI 봇이 특정 글을 마크다운으로 요청했는데 캐시 서버가 이를 그대로 저장해 버리면, 직후에 같은 주소로 접속한 일반 사람 독자에게도 화면 디자인이 없는 마크다운 텍스트가 그대로 노출되는 사고가 발생한다. 이를 방지하기 위해 응답 헤더에 `Vary: Accept`를 명시하여, **“요청한 쪽의 `Accept` 헤더 종류(HTML인지 Markdown인지)에 따라 캐시를 별도로 분리해서 저장하라”**고 지시했다.
- **헤더만 보고도 길을 찾는 HTTP `Link` 헤더 (RFC 8288)**: AI 에이전트가 본문 전체를 내려받기 전에 가벼운 `HEAD` 요청만 보내더라도 사이트의 주요 통로를 즉시 발견할 수 있도록, 모든 HTTP 응답 헤더에 API 카탈로그 위치(`rel="api-catalog"`)와 REST API 진입점(`rel="service-desc"`)을 가리키는 링크를 심어 두었다.
```
# AI 에이전트가 순수 마크다운 본문을 요청할 때의 실제 HTTP 응답 헤더
curl -i -H "Accept: text/markdown" https://mixedlog.com/archives/1963
HTTP/1.1 200 OK
Content-Type: text/markdown; charset=utf-8
Vary: Accept
Content-Signal: ai-train=yes, search=yes, ai-input=yes
Link: ; rel="api-catalog", ; rel="service-desc"
```
### 3.2 llms.txt와 llms-full.txt: 토큰 경제성과 컨텍스트 윈도우 최적화
이번 작업에서 특히 공을 들인 부분은 사이트 루트 경로에 배치한 **`llms.txt`**와 **`llms-full.txt`**다. 한마디로 비유하면 **‘AI 전용 도서관의 층별 안내도(`llms.txt`)’와 ‘대표 저작 전권 합본(`llms-full.txt`)’**이다.
기존에도 웹사이트에는 검색엔진 로봇을 위한 `sitemap.xml`이 있었다. 그렇다면 왜 AI를 위해 별도의 파일이 필요할까? 기술적인 이유는 크게 두 가지다.
- **맥락(Context)과 우선순위의 부재**: `sitemap.xml`은 사이트 안의 수백 개 URL과 수정 날짜(``)만 기계적으로 나열된 전화번호부에 가깝다. AI 에이전트가 이 목록만 보고서는 어느 주소가 블로그의 정체성을 담은 핵심 논문이고 어느 주소가 단순한 태그 목록 페이지인지 알 수 없다.
- **토큰(Token) 낭비와 컨텍스트 윈도우(Context Window) 오염**: 거대언어모델(LLM)이 한 번에 읽고 기억할 수 있는 작업 공간(컨텍스트 윈도우)은 유한하며, 읽어들인 글자 수(토큰)에 비례해 연산 시간과 비용이 증가한다. 일반적인 웹페이지 HTML을 그대로 긁어가면 전체 용량의 70~80%가 메뉴바, 스크립트, 스타일 태그 같은 노이즈여서 AI의 추론 정확도가 떨어지고 응답 속도(TTFT)도 느려진다.
이러한 문제를 해결하기 위해 Answer.AI의 제레미 하워드(Jeremy Howard) 등이 제안한 규격이 바로 **`llms.txt`**다. 사이트 루트(`/llms.txt`)에 마크다운 형식으로 사이트 요약, 카테고리 구조, 대표 글 링크와 한 줄 설명을 정리해 두어 AI가 최소한의 토큰만으로 사이트 전체 지형도를 파악하게 돕는다.
- **`/llms.txt` (핵심 구조 안내서, 약 2.5KB)**: 표준 규격에 맞춰 `# 사이트 제목`, `> 한 줄 요약 인용구`, 그리고 `## 섹션별 링크 목록` 순으로 구성했다. 초기 파일에서 워드프레스의 실제 퍼머링크 구조(`/archives/category/...`)와 맞지 않아 `404 Not Found`를 내던 카테고리 주소 6개를 모두 바로잡고, 웹서버 설정에서 `Content-Type: text/plain; charset=utf-8`을 강제하여 다바이트(Multi-byte) 한글 문자열이 깨지는 현상(Mojibake)을 해결했다.
- **`/llms-full.txt` (핵심 연구 전문 코퍼스, 약 96KB · 3,000여 줄)**: 안내도에서 한 걸음 더 나아가, 한 번에 수십만 토큰을 읽을 수 있는 최신 LLM과 RAG(검색 증강 생성) 시스템을 위해 **대표 논문 및 비평 4편의 본문 전체, 표, 수식, 참고문헌을 하나의 마크다운 파일에 온전히 담아낸 합본**이다. 기존에는 파일 이름만 `full`이고 내용은 `/llms.txt`와 똑같은 30줄짜리 링크 목록에 불과했으나, 실제 데이터베이스에서 대표 글들의 전문을 추출해 마크다운으로 변환·병합함으로써 AI가 단 한 번의 HTTP 요청만으로 블로그의 핵심 학술 연구들을 통독할 수 있게 만들었다.
```
# https://mixedlog.com/llms.txt 실제 구조 발췌
# mixedlog
> An editorial space exploring research, criticism, technology, cycling, and daily logs.
## Content Sections
- [연구 & 비평](https://mixedlog.com/archives/category/essays): In-depth research papers on media theory, VR immersive theater, archaeology, and cultural criticism.
- [테크 & 코드](https://mixedlog.com/archives/category/tech): Software engineering, web development, cloud architecture, and infrastructure notes.
- [서평](https://mixedlog.com/archives/category/book-reviews): Book reviews and literary reflections.
- [자전거](https://mixedlog.com/archives/category/velo): Long-distance cycling logs, route analysis, and equipment notes.
- [아카이브 & 번역](https://mixedlog.com/archives/category/archive): Archival records, essays, and translations.
- [일상 로그](https://mixedlog.com/archives/category/journal): Personal essays and daily reflections.
## Machine-Readable Resources
- [Full Text Knowledge Base](https://mixedlog.com/llms-full.txt): Complete full-text markdown of cornerstone articles for large language models.
- [REST API](https://mixedlog.com/wp-json/wp/v2/posts): Public read-only WordPress REST API.
```
### 3.3 브라우저 내장 AI를 위한 ‘WebMCP’와 표준 디스커버리 명세(RFC 9727)
사람이 웹사이트에서 원하는 주제를 찾을 때는 눈으로 돋보기 모양 아이콘을 찾아 검색창에 글자를 입력한다. 과거의 브라우저 자동화 AI들은 사람처럼 화면을 캡처해 버튼 위치를 추측하고 마우스 클릭을 흉내 내느라 속도가 느리고 화면 디자인이 조금만 바뀌어도 오작동하곤 했다.
이를 해결하기 위해 W3C 커뮤니티 그룹 등에서 논의되고 있는 차세대 웹 인터페이스 제안이 바로 **WebMCP(Web Model Context Protocol)**다. 웹페이지가 브라우저의 `navigator.modelContext` 인터페이스를 통해 **“이 페이지에서는 이런 이름의 함수를 이런 입력값(JSON Schema)으로 호출하면 원하는 작업을 바로 실행할 수 있다”**고 AI 에이전트에게 직접 도구(Tool)를 건네주는 기술이다.
`mixedlog.com`에는 두 가지 방식의 WebMCP 도구가 구현되어 있는데, 앞서 브라우저 감사 AI가 찾아낸 콘솔 에러의 원인과 해결 과정은 다음과 같다.
- **선언형(Declarative) HTML 검색 폼 도구 (`search_mixedlog`)**: 사이트 하단 `